排序演算法
排序演算法的重點整理。
Sorting 名詞解釋整理
Sorting Problem 定義
-
輸入 (Input):一個含有 \(n\) 個數字的序列 \(\langle a\_1, a\_2, \ldots, a\_n \rangle\)。
-
輸出 (Output):輸入序列的一個排列 \(\langle a'\_1, a'\_2, \ldots, a'\_n \rangle\),滿足:\(a'_1 \leq a'_2 \leq \cdots \leq a'_n\)
-
資料結構:通常用陣列表示,也可用 linked list。
-
紀錄 (Record):每筆資料包含 鍵 (Key) 與 附屬資料 (Satellite Data)。排序時必須保證鍵與附屬資料一同搬移。
為什麼排序重要 (Why Sorting)
-
某些應用需要直接排序,例如銀行需依支票號碼排序。
-
排序常作為其他演算法的子程序 (subroutine)。
-
排序演算法種類多,蘊含豐富的設計技巧與歷史價值。
-
可證明非平凡下界 \(\Omega(n \log n)\),部分排序演算法已達漸進最優。
-
工程上挑戰:快取、記憶體階層、附屬資料大小、軟體環境,都影響實作效能。
Internal vs External Sorting
-
Internal Sorting:資料量小,能完全放入記憶體中處理。
-
External Sorting:資料量太大,無法一次放入記憶體,需要外部儲存裝置 (如磁碟) 協助,例如多路合併排序 (multi-way merge)。
Stable vs Unstable Sorting
-
Stable Sorting:若輸入有相同鍵值,排序後相對順序保持不變。
-
Unstable Sorting:排序後相同鍵值的相對順序可能改變。
範例分類:
-
Stable:Insertion sort、Bubble sort、Merge sort、Radix sort、Bucket sort、Counting sort (IBM)。
-
Unstable:Selection sort、Shell sort、Quick sort、Heap sort。
補充:
-
Stable 在處理附屬資料時很重要,例如排序結構化紀錄。
-
Unstable 可能進行不必要的交換,但排序時間不一定比較慢。
Sorting In-Place
-
定義:演算法只需常數額外空間 (O(1)) 即可完成排序。
-
特性:直接在輸入陣列內完成資料搬移。允許少量變數。
分類:
-
In-place:Insertion、Bubble、Heap、Quick。
-
非 In-place:Merge、Counting、Radix、Bucket。
常見排序演算法複雜度
| Algorithm | Worst-case | Average / Expected | In-place | Stable |
|---|---|---|---|---|
| Insertion sort | \(\Theta(n^2)\) | \(\Theta(n^2)\) | ✔ | ✔ |
| Merge sort | \(\Theta(n \log n)\) | \(\Theta(n \log n)\) | ✘ | ✔ |
| Heapsort | \(O(n \log n)\) | \(O(n \log n)\) | ✔ | ✘ |
| Quicksort | \(\Theta(n^2)\) | \(\Theta(n \log n)\) (期望) | ✔ | ✘ |
| Counting sort | \(\Theta(k+n)\) | \(\Theta(k+n)\) | ✘ | ✔ |
| Radix sort | \(\Theta(d(n+k))\) | \(\Theta(d(n+k))\) | ✘ | ✔ |
| Bucket sort | \(\Theta(n^2)\) | \(\Theta(n)\) (平均) | ✘ | ✔ |
Insertion sort
void insertion_sort(int arr[],int n){
	for(int i=1;i<n;i++){
		int j=i-1;
		int key = arr[i];
		while(j>=0 && key < arr[j]){ // 這邊就是插入
			arr[j+1] = arr[j]; // 慢慢地往右邊放如果找到比 key 還要大的
			j--; // 往左邊檢查
		}
		arr[j+1]=key; //最後放的位置也就是 key 要放在某個找到比他還小的 arr[j] 然後放在他的右邊
	}
}
Insertion Sort 分析
| Case | 複雜度 | 說明 |
|---|---|---|
| Best case | \(O(n)\) | 當輸入資料原本就是由小到大排序時。遞迴式:\(T(n) = T(n - 1) + 1\) |
| Worst case | \(O(n^2)\) | 當輸入資料原本是由大到小排序時。遞迴式:\(T(n) = T(n - 1) + (n - 1)\) |
| Average case | \(O(n^2)\) | 平均情況下的時間複雜度。遞迴式:\(T(n) = T(n - 1) + c n\) |
-
\(O(1)\):原地排序,不需要額外記憶體。
-
✅ Stable:插入排序是穩定的排序演算法,最主要是在
while(key < arr[j])因為不成立所以不會被交換所以就是保持原本的 order 所以是 stable。 -
適用情景
-
當資料記錄數量少時,Insertion Sort 已足夠,無需使用快速排序等複雜演算法。
-
當資料已經排序 (sorted) 或 幾乎排序 (almost sorted) 時,Insertion Sort 或 Bubble Sort 表現良好。
-
複雜度證明
Best Case:\(O(n)\)
情境:輸入資料原本就由小到大排列(min → max)。
方法 1:統計比較或 swap 次數
-
因為 \(key > arr[j]\),
while條件不成立,不會進入內層迴圈。 -
每個元素都直接插入正確位置。
-
需要比較 \((n - 1)\) 次即可完成排序。
方法 2:遞迴時間模型
-
假設 \(T(n)\) 為排序 \(n\) 筆資料的時間。
-
第 \(n\) 筆插入只需 1 次比較。
-
第一筆不需比較(\(T(1) = 0\))。
展開:
因此最佳情況時間複雜度為:
Worst Case:\(O(n^2)\)
情境:輸入資料為反序(由大到小)。
方法 1:統計比較次數
-
每次插入都必須和所有已排序元素比較。
-
第 2 筆比較 1 次,第 3 筆比較 2 次,⋯⋯ 第 \(n\) 筆比較 \((n - 1)\) 次。
總比較次數:
因此:
方法 2:遞迴時間模型
- 第 \(n\) 筆資料插入時要比較 \((n - 1)\) 次。
展開:
因為 \(T(1) = 0\):
Average Case:\(O(n^2)\)
情境:輸入資料為隨機排列。
-
平均每次插入時需要比較一半的元素。
-
第 \(k\) 次插入平均比較 \(\dfrac{k}{2}\) 次。
總比較次數:
因此:
Horowitz 分析補充(LOO 概念)
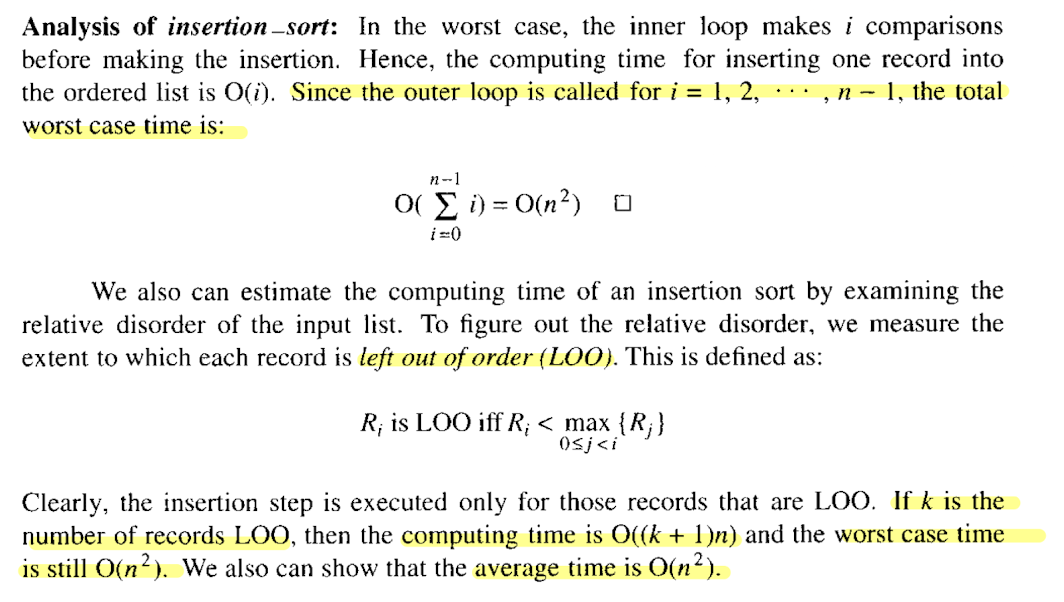
Horowitz 用 LOO(Left Out of Order)衡量輸入序列的無序程度:
-
思考方式
-
✅ LOO 就是「無序程度」的量化指標。
-
✅ 如果 LOO(記作 k)很多,代表左邊常常有比自己大的元素,
while幾乎每次都會執行,程式就會出現兩層迴圈 → 比較次數多、移動次數多 → 時間複雜度趨近 \(O(n^2)\)。 -
✅ 如果 LOO 很少(例如資料幾乎已排序),
while幾乎不會進入,很多元素只需 1 次比較 → 複雜度趨近 \(O(n)\)。
-
- 若 \(R_i\) 左邊有比它大的元素,則 \(R_i\) 是 LOO:
-
插入排序的成本主要來自 LOO 元素,因為它們才會觸發內層
while。 -
若有 \(k\) 個元素是 LOO,時間複雜度為:
- 若 \(k = n - 1\)(完全亂序),則:
- 若 \(k\) 很少(幾乎有序),時間接近 \(O(n)\)。
插入排序的兩種變形與改進
插入排序(Insertion Sort)可分為兩種主要改進方向:
-
Binary Insertion Sort(二分插入排序)
-
Linear Insertion Sort(線性插入排序 / 鏈結串列)
原始(標準)Insertion Sort 回顧
-
每次插入要做兩件事:
-
尋找插入位置(線性搜尋) → \(O(n)\)
-
元素右移插入(資料搬移) → \(O(n)\)
-
-
總體時間複雜度:\((n - 1) \times O(n) = O(n^2)\)
Binary Insertion Sort(二分插入排序)
改進重點
-
使用 Binary Search 尋找插入位置(前提:前段為已排序陣列)時間複雜度:\(O(\log n)\)
-
仍需使用陣列搬移(Random Access)時間複雜度:\(O(n)\)
成本分析
-
單次插入時間:\(O(\log n) + O(n) = O(n)\)
-
總體時間複雜度:\(O(n^2)\)
📌 優點:比較次數減少。
📌 缺點:資料搬移次數未改善。
Linear Insertion Sort(線性插入排序 / 鏈結串列)
改進重點
-
尋找插入位置仍為 線性搜尋 時間複雜度:\(O(n)\)
-
使用 鏈結串列 儲存資料 → 插入時僅改指標,不需整體搬移 插入時間:\(O(1)\)
成本分析
-
單次插入時間:\(O(n) + O(1) = O(n)\)
-
總體時間複雜度:\(O(n^2)\)
📌 優點:資料搬移成本降低。
📌 缺點:比較次數未改善。
三種版本比較
| 版本 | 尋找插入位置 | 搬移資料 | 單次插入時間 | 總體複雜度 | 優點 |
|---|---|---|---|---|---|
| 標準 Insertion Sort | \(O(n)\) | \(O(n)\) | \(O(n)\) | \(O(n^2)\) | 實作簡單 |
| Binary Insertion Sort | \(O(\log n)\) | \(O(n)\) | \(O(n)\) | \(O(n^2)\) | 減少比較次數 |
| Linear Insertion Sort | \(O(n)\) | \(O(1)\) | \(O(n)\) | \(O(n^2)\) | 減少搬移成本 |
-
無論使用 Binary Search 還是 Linked List,整體時間複雜度都仍為 \(O(n^2)\)。
-
改進的重點是降低「常數因子」和提升實際執行效率,而非改變漸進複雜度。
Shell’s Sort
Shell Sort(希爾排序)是由 Donald L. Shell 在 1959 年提出的一種改良版插入排序(Insertion Sort)。其核心思想源自對插入排序的效能瓶頸的觀察與改進。
在經典插入排序中,若資料的初始狀態為「逆序」,每次插入操作都可能導致大量元素的位移,時間複雜度為 \(O(n^2)\)。這種情況在大型資料集中特別明顯,使得插入排序的效率無法滿足實際需求。Shell 的研究動機正是為了解決這個問題:如何降低插入排序在遠距離元素交換時的代價。
Shell 在原始論文中指出,傳統的排序方法主要分為兩類:「兩兩交換」與「插入移動」,而插入排序雖然在接近有序時非常快速,但在元素分布無序的情況下效率低下。為了結合「插入排序的穩定性」與「減少資料移動距離」的優點,他提出了分段處理的概念:將資料按照一定間隔(gap)分組,對每組使用插入排序,隨後逐步縮小 gap,直到 gap = 1 完成排序。
這種「分組插入」的方式,讓遠距離的元素能在早期階段就移動到接近最終位置,顯著減少了後期插入的移動次數。最終當 gap = 1 時,資料已經「幾乎有序」,因此最後一輪插入排序的開銷大幅降低。
Shell 的原始論文同時探討了當時內部排序演算法的各種瓶頸,包括記憶體受限的環境下如何高效排序大規模資料。Shell Sort 的提出不僅提升了插入排序的效率,也奠定了後續眾多改進演算法(如 Sedgewick 間隔序列)的理論基礎。
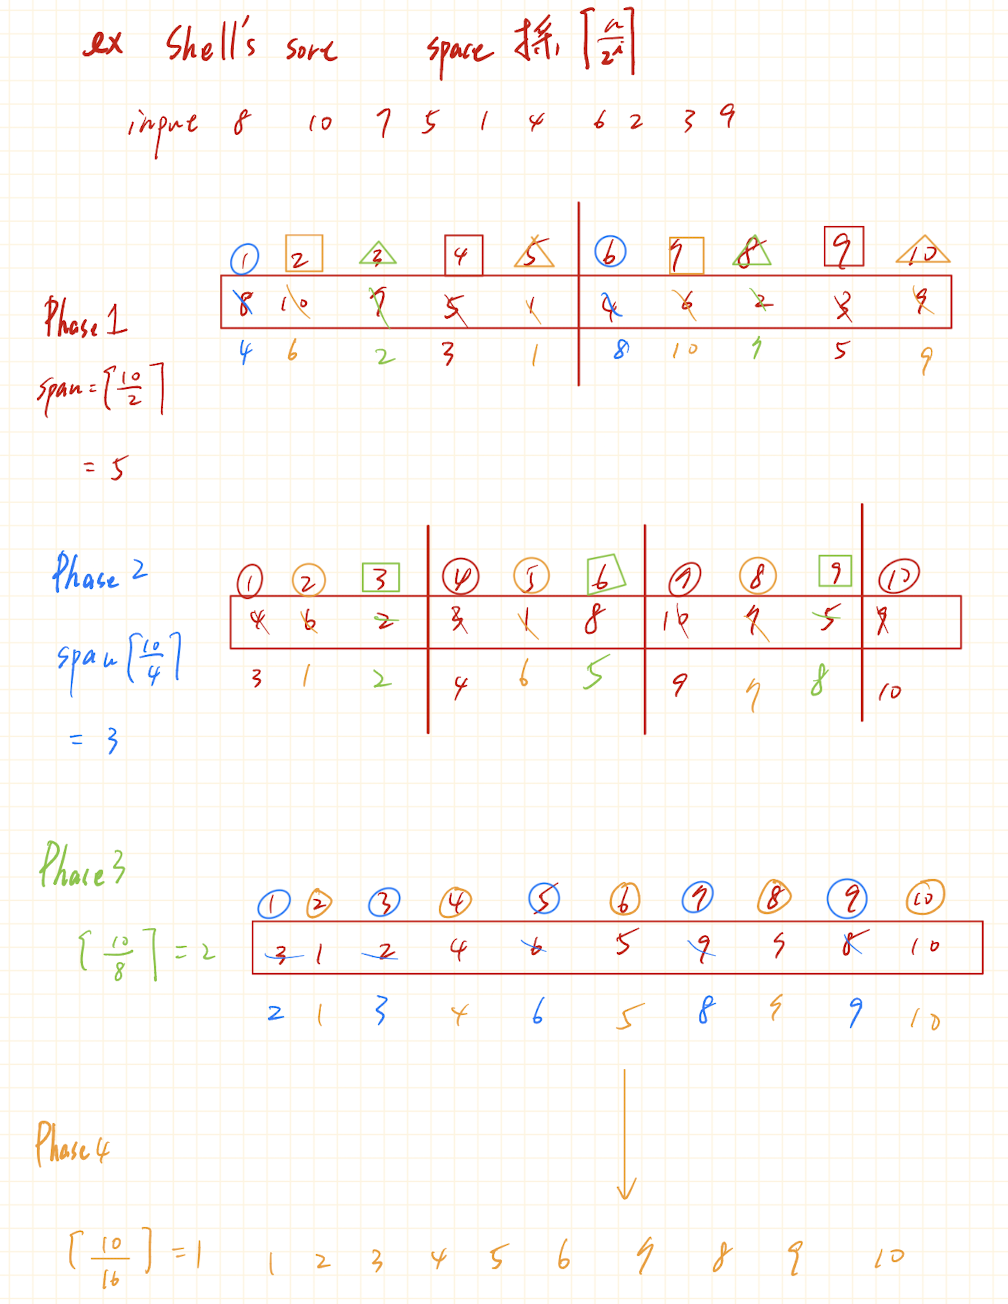
void shellSort(vector<int>& arr) {
    int n = arr.size();
    int gap = n / 2;

    while (gap > 0) {
        for (int j = 0; j < n - gap; j++) { // 設定 n-gap 例如 10 他只會執行到 7
            int i = j; // 這個是為了找到對應的 element
            while (i >= 0 && arr[i] > arr[i + gap]) { // 對應的元素需不需要交換
                swap(arr[i], arr[i + gap]);
                i -= gap; // 還原 i 的位置方便下一次找對應元素,並且找前幾個 index,例如是 7 就可以找 index 4 和 1
            }
        }
        gap /= 2; // 間隔縮小
    }
}
Shell’s Sort 分析
時間複雜度(依 gap 序列而定):
| 情況 | 時間複雜度 | 說明 |
|---|---|---|
| 最佳情況(Best case) | \(O(n) \text{ to } O(n^{3/2})\) | 視 gap 選擇而定,若初始資料已排序則近似 \(O(n)\)。常見分析寫 \(O(n^{3/2})\)。 |
| 最壞情況(Worst case) | \(O(n^2)\) | 最壞情況下退化為與插入排序相同的複雜度。 |
| 平均情況(Average case) | \(O(n^{3/2}) \text{ to }O(n^{7/6})\) | 平均效率遠優於插入排序,依 gap 不同而略有變化。 |
-Span 形式(gap 選擇):
-
常見的 gap 設定方式有:
-
\(\frac{n}{2}, \frac{n}{4}, \frac{n}{8}, \dots, 1\)
-
\(2^k - 1\) 型
-
其他自行設計的 gap 序列
-
-
無論選擇哪種形式,最後一個 gap 必須為 1,以確保最終結果完全排序。
空間複雜度:
- \(O(1)\)(就地排序,不需額外空間)
穩定性:
- 不穩定排序(Unstable),因為跨距較大時交換可能改變相同鍵值元素的相對順序。
補充說明:
-
Shell Sort 是插入排序的改進版本,透過逐步縮小 gap 的方式,讓資料在最後階段已接近排序完成,使得最終一次 gap=1 的插入排序能以接近線性的速度完成。
-
時間複雜度無明確封閉解,取決於 gap 序列的選擇。經典分析多以 \(O(n^{3/2})\) 作為平均情況的近似值。
-
已知最佳的 gap 設計可使 Shell Sort 的時間複雜度達到 \(O(n^{7/6})\),但考試與實務中常使用 \(O(n^{3/2})\) 表達。
Selection Sort
-
它的流程是:
-
找出整個剩餘區間的最小值索引
min_index -
最後再把它和目前位置
i交換(一次交換)
-
#include <bits/stdc++.h>

using namespace std;

void selection_sort(int arr[],int n){
  for (int i=0;i<n-1;++i){
    int min_index = i;
    for(int j=i+1;j<n;j++){
      if(arr[i]<arr[min_index]) min_index = j;
    }
    if(i != min) swap(arr[i],arr[min_index])
  }
}

int main() {
  int arr[] = {64, 25, 12, 22, 11};
  int n = sizeof(arr) / sizeof(arr[0]);

  selection_sort(arr, n);

  cout << "Sorted array: ";
  for (int i = 0; i < n; ++i) {
    cout << arr[i] << " ";
  }
  cout << endl;

  return 0;
}
Selection Sort 分析
選擇排序的時間複雜度在最佳、最壞與平均情況下皆為 \(O(n^2)\),因為外層迴圈會執行 \(n - 1\) 次,而內層每次都要比較剩餘的元素。總比較次數為:
不論輸入資料是已排序、反序或隨機,這個比較次數都不會改變,因此三種情況下的時間複雜度都一樣。空間複雜度是 \(O(1)\),因為它是原地排序,不需要額外記憶體。
選擇排序是不穩定的,因為在找到最小值後會與目前位置的元素交換,這可能改變相同元素的相對順序。它適合用在大型紀錄或交換成本高的情況,因為每輪最多只交換一次。
以下是排序過程的例子,假設原始序列為:5 8 5 2
-
Pass 1:找到最小值
2,與第一個元素交換 →2 8 5 5 -
Pass 2:在剩下的部分中找到最小值
5,與第二個元素交換 →2 5 8 5 -
Pass 3:找到最小值
5,與第三個元素交換 →2 5 5 8
最終結果為:2 5 5 8
從程式碼角度來看,總比較次數也能清楚看出,這段程式會做 \((n - 1) + (n - 2) + \dots + 1\) 次比較,總共 \(\frac{n(n - 1)}{2}\) 次,因此時間複雜度是 \(O(n^2)\)。
總結來說,選擇排序的時間複雜度在三種情況下都是 \(O(n^2)\),空間複雜度是 \(O(1)\),是不穩定排序,每輪最多交換一次,適合交換成本高的場景使用。
Bubble Sort
泡沫排序(Bubble Sort)是一種基於「相鄰元素比較與交換」的簡單排序演算法。基本概念是:從左到右反覆比較相鄰元素,若前一項大於後一項則交換,讓最大值逐步浮到最右邊,就像氣泡上升一樣。
每一次外層迴圈稱為一個 Pass,在第 \(i\) 次 Pass 結束後,最大的 \(i\) 個元素都會被放到正確位置。最多需要進行 \((n - 1)\) 次 Pass。
void bubbleSort(int arr[], int n) {
    int i, j, flag;
    for (i = 0; i < n - 1; i++) {
        flag = 0; // 檢查本輪是否發生過交換
        for (j = 0; j < n - 1 - i; j++) {
            if (arr[j] > arr[j + 1]) {
                swap(&arr[j], &arr[j + 1]);
                flag = 1; // 若有交換則設為 1
            }
        }
        if (flag == 0) break; // 若本輪無交換,表示已排序完成
    }
}
-
flag的用途:最佳化演算法效率。-
若某次 Pass 中沒有發生交換,表示資料已經完全排序好,不需再執行後續 Pass,可提前結束。
-
若不使用
flag,即使已排序完成,仍會執行 \((n - 1)\) 次外層迴圈,時間複雜度維持 \(O(n^2)\)。 -
使用
flag可讓最佳情況(Best Case)降為 \(O(n)\)。
-
-
執行過程示例(以
[5, 3, 8, 2, 1]為例):-
Pass 1:\([3, 5, 2, 1, 8]\)
-
Pass 2:\([3, 2, 1, 5, 8]\)
-
Pass 3:\([2, 1, 3, 5, 8]\)
-
Pass 4:\([1, 2, 3, 5, 8]\)
-
Bubble Sort 分析
| 項目 | 最佳情況 (Best case) | 最壞情況 (Worst case) | 平均情況 (Average case) |
|---|---|---|---|
| 時間複雜度 | \(O(n)\) | \(O(n^2)\) | \(O(n^2)\) |
| 空間複雜度 | \(O(1)\) | \(O(1)\) | \(O(1)\) |
| 穩定性 | 穩定(Stable) | 穩定(Stable) | 穩定(Stable) |
-
最佳情況分析(Best Case)
-
當輸入資料原本就是由小到大排序時,整個排序過程中不會發生任何交換。
-
在程式中,
flag會在第一輪檢查後發現沒有 swap,演算法立即結束,因此時間複雜度為:\(T(n) = n - 1 \approx O(n)\) -
例如輸入為
[1, 2, 3, 4, 5]: -
Phase 1 比較 \((n-1)\) 次,沒有交換。
-
flag = 0→ 跳出外層迴圈。 -
整體複雜度 \(O(n)\)。
-
-
最壞情況分析(Worst Case)
-
當輸入資料是完全反序(由大到小)時,會觸發最多次的比較與交換。
-
每次 Pass 都需要 \((n - i - 1)\) 次比較:\(T(n) = (n - 1) + (n - 2) + \cdots + 1 = \frac{n(n - 1)}{2} = O(n^2)\)
-
例如輸入為
[5, 4, 3, 2, 1]: -
Pass 1:\((n - 1)\) 次比較,最大值移到最後。
-
Pass 2:\((n - 2)\) 次比較,次大值移到倒數第二。
-
… 直到排序完成。
-
-
平均情況分析(Average Case)
-
平均情況下,元素約一半需要移動,每輪比較次數與最壞情況同階。
-
時間複雜度依然為:
-
逐步展開:
因此
關鍵:明確指定 基底(例如 \(T(1)=0\) 或 \(T(0)=0\))。這樣在展開到最後一項時,就能把 \(T(1)\)(或 \(T(0)\))直接代入為 0,尾端項自然消失。
- Best case(Bubble / Insertion):
展開:
- Worst case(Insertion 典型推導):
展開:
只要在一開始就給出 正確的基底值,像 \(T(n-2)\)、\(T(n-3)\) 這些遞迴尾巴在展開鏈條的最後都會落到 \(T(1)\) 或 \(T(0)\),用基底直接歸零即可。
Quick sort
觀念與策略
**平均情況下最快的比較式內部排序法。**核心採用 Divide and Conquer:
-
Divide(分割):選一個 pivot(常取端點或隨機),對區間做 partition,把陣列切成兩側:左側元素皆 ≤ pivot,右側元素皆 ≥ pivot(Hoare 版本中,pivot 不一定落在最終索引)。
-
Conquer(征服):遞迴地對左右兩個子區間分別套用 quick sort。
-
Combine(合併):不需額外合併;當左右子區間都排好,整體即為有序。
直觀理解:一次「把 pivot 放到正確區側並分治」,重複此過程;若每次分得接近等大,整體時間為 \(\Theta(n\log n)\),這就是它在平均情況下極快的原因。
Partition (Divide)方法
其實就是如何選擇 Pk 之最正確之位置,左側 ≤ pivot,右側 ≥ pivot。
Hoare partition
-
常用:
pivot = A[l](也可隨機/取中位數),但是基本型都是設定最左邊。 -
指標:
i自左、j自右內縮;各自尋到違規元素就交換;i ≥ j回傳p = j。 -
特性:pivot 不一定在最終索引;遞迴區間
[l..p]、[p+1..r]。-
best case : 是全部元素都相同
-
worst case : 就是全部元素都排序好
-
void quicksort(int arr[],int left,int right){
	int pivot=arr[left],i=left,j=right+1;
	do {
		do {i++} while(arr[i] < pivot);
		do {j--} while(arr[j]> pivot);
		if(i<j) swap(arr[j],arr[i]);
	} while(i<j);
	swap(arr[left],arr[j]);
	quicksort(arr,left,j-1);
	quicksort(arr,j+1,right);
}
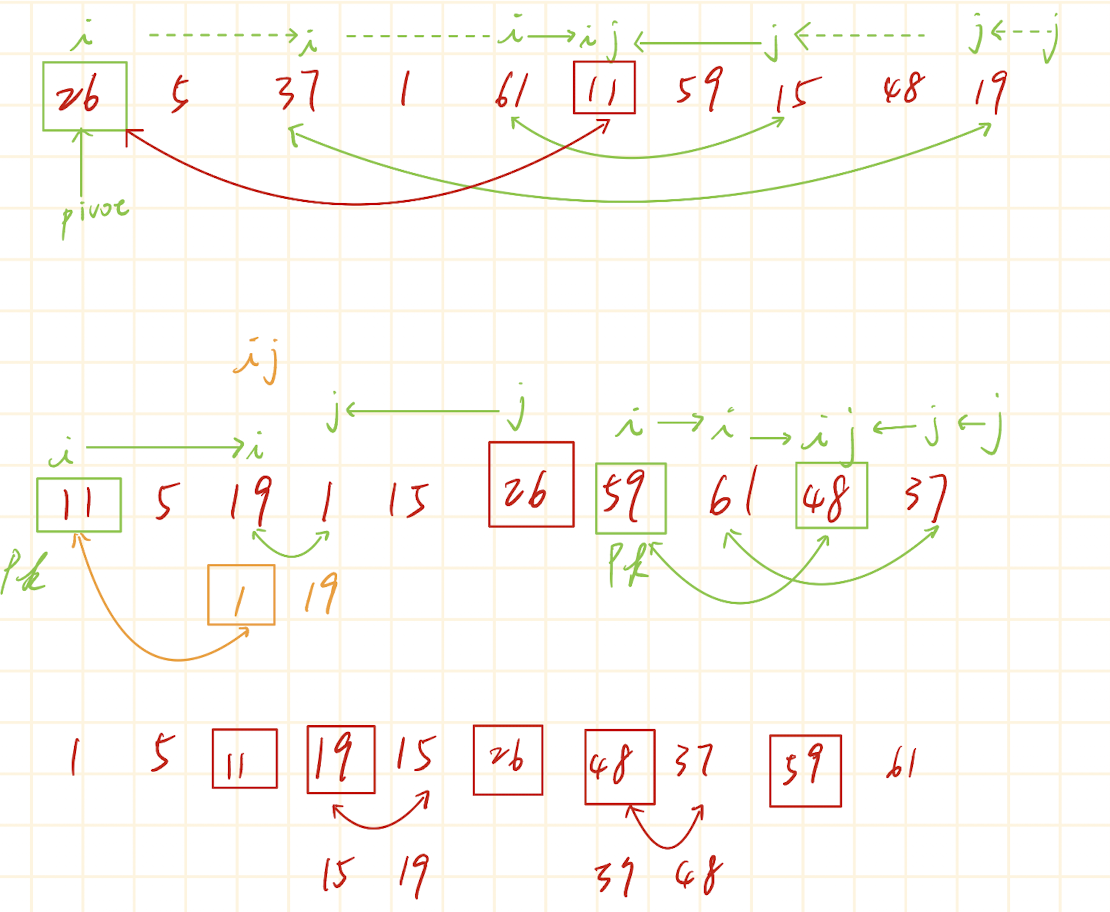
Lomuto partition(Cormen/CLRS)
-
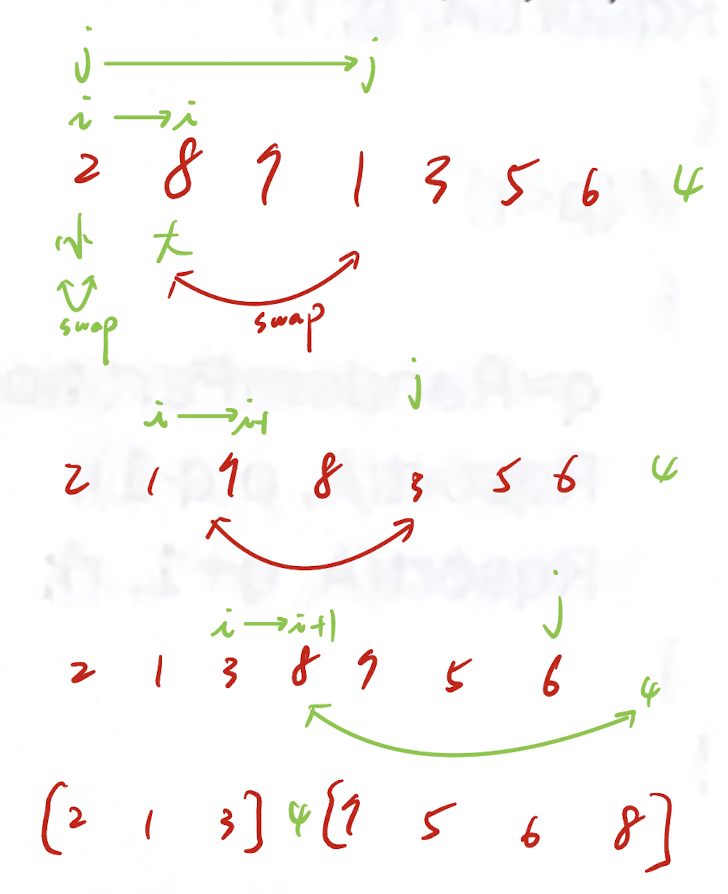
常用:
pivot = A[r],設定在最右邊。 -
指標:
i = l-1,j = l..r-1;遇到A[j] ≤ pivot先增i再與A[j]交換;最後把 pivot 與A[i+1]交換並回傳i+1。 -
特性:pivot 一定被放到最終索引;實作簡單但對大量重複鍵較易退化。
- worst case : 就是 Hoare 的 best case 也就是全部元素相同,解決辦法有兩種改用 Hoare 的 partition 或是先檢查所有元素是否相同花費 \(O(n)\) 時間,但不影響總體時間 \(O(n\log n)\)
def partition(A, p, r):
    pk = A[r]; i = p-1
    for j in range(p, r):
        if A[j] <= pk:
            i += 1; A[i], A[j] = A[j], A[i]
    A[i+1], A[r] = A[r], A[i+1]
    return i+1  # q

def quicksort(A, p, r):
    if p < r:
        q = partition(A, p, r)
        quicksort(A, p, q-1)
        quicksort(A, q+1, r)
Quick Sort 分析
核心:
partition單次成本 \(\Theta(n)\)。整體取決於分割的平衡度。
時間複雜度總覽
| 情況 | 遞迴式 | 道理 | 結論 |
|---|---|---|---|
| Best | \(T(n)=2T(\tfrac{n}{2})+cn\) | 資料串列恰巧切成 2 等份 | \(\Theta(n\log n)\) |
| Worst | \(T(n)=T(n-1)+cn\) | 切在 (最左或是最右) 最大或是最小,所以剩下 n-1 筆資料遞迴 | \(\Theta(n^2)\) |
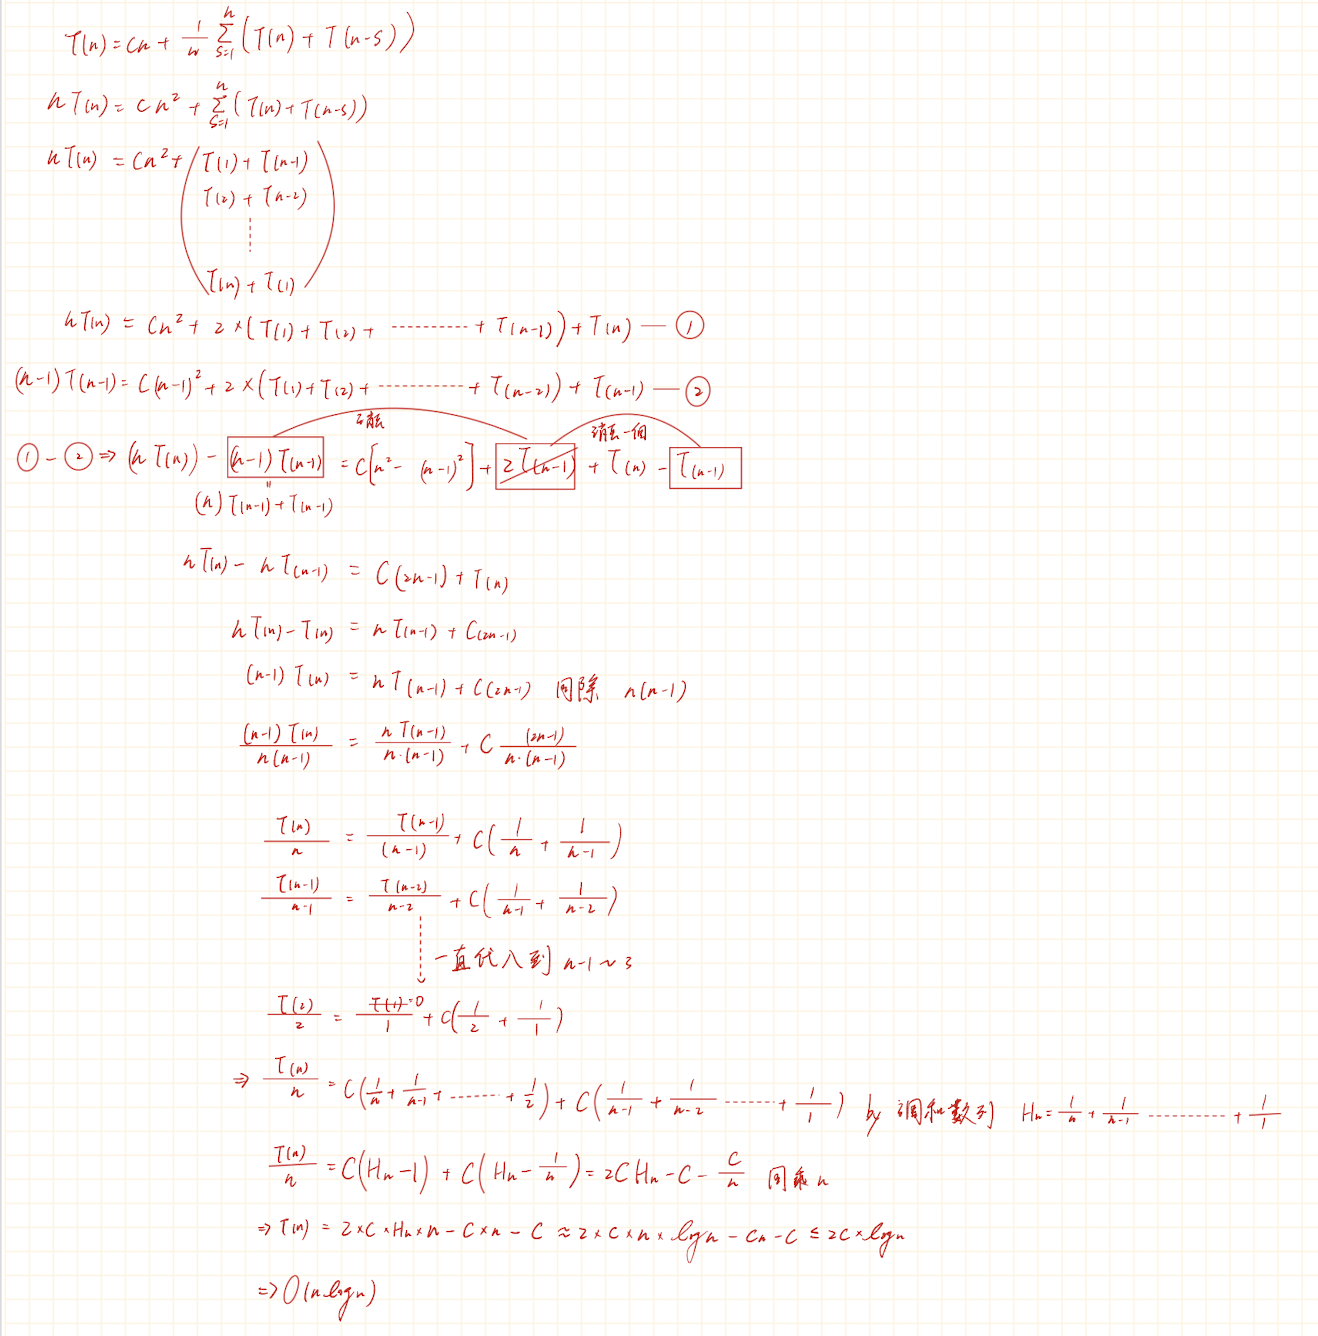
| Average | \(T(n)=cn+\dfrac{1}{n}\sum_{i=0}^{n-1}\big(T(i)+T(n-1-i)\big)\) | \(\Theta(n\log n)\) |
-
每層 partition cost ≈ \(c\times n\)。
-
層數:
-
近似對半(或固定比例如 \(n/3\) 與 \(2n/3\))⇒ \(\log n\) 層 ⇒ \(\Theta(n\log n)\)。
-
極端不平衡(pivot 為最小/最大)⇒ \(n\) 層 ⇒ \(\Theta(n^2)\)。
-
遞迴式推導
-
Best:Master 定理 \(a=2, b=2, f(n)=\Theta(n)\) ⇒ \(\Theta(n\log n)\)。
-
Worst:展開 \(T(n)=c\sum_{k=1}^{n-1}k=\Theta(n^2)\)。
-
Average:所有切點等機率,期望高度 \(\Theta(\log n)\) ⇒ 總成本 \(\Theta(n\log n)\),可以想像切分了 \(n\) 和 \(n-s\)。
空間複雜度分析(recursive stack)
-
重點概念
-
stack size depends on recursive call 深度。
-
記:此處只討論遞迴棧,不含就地交換所用的暫存。
-
-
Best case(近似對半切)
-
每次 partition 後,兩側大小約為 (n/2)。
-
遞迴樹高度: \(\frac{n}{2^{k}} = 1 \Rightarrow k = \log_2 n.\)
-
棧深 = 層數 (k) ⇒ 空間複雜度: \(\boxed{O(\log n)}\)
-
-
Worst case(總落在極端)
-
每次切成 \(0\) 與 \(n-1\)(或等價地,連續:(n-1, n-2, \(\dots\), 1))。
-
遞迴樹高度: \(k = n-1\)
-
棧深 = (k) ⇒ 空間複雜度: \(\boxed{O(n)}\)
-
改善 Worst case 方法
Worst Case 概要
-
來源:每次分割產生 \(n-1\) 與 \(0\) 的子問題(pivot 總落在極端)。
-
單層成本:\(\Theta(n)\)(一次 partition 掃描)。
-
遞迴式:\(T(n)=T(n-1)+\Theta(n)\)。
-
結果:\(T(n)=\Theta(n^2)\)(等差級數展開)。
-
典型觸發:
-
輸入已排序或反向排序且 pivot 取端點(如 Lomuto 取 \(A[r]\))。
-
大量相等鍵且分割把「等於」都丟同側。
-
改進策略一:Randomized QuickSort(隨機 pivot)
procedure RQSort(A, p, r):
    if p >= r: return
    q ← RandomPartition(A, p, r)
    RQSort(A, p, q-1)
    RQSort(A, q+1, r)

procedure RandomPartition(A, p, r):
    i ← UniformRandomInteger(p, r)
    swap(A[i], A[r])
    return LomutoPartition(A, p, r)

procedure LomutoPartition(A, p, r):
    x ← A[r]
    i ← p-1
    for j ← p to r-1:
        if A[j] ≤ x:
            i ← i+1
            swap(A[i], A[j])
    swap(A[i+1], A[r])
    return i+1
想法:打散輸入與 pivot 的關聯,降低連續極端切分機率。
-
介面:
RandomPartition(A,p,r)-
隨機選 \(i\in[p,r]\);交換 \(A[i]\) 與 \(A[r]\)。
-
呼叫一般
Partition(A,p,r),回傳 \(q\)。
-
-
性質:
-
期望/平均時間:\(\Theta(n\log n)\)。
-
最壞時間:仍可能 \(\Theta(n^2)\),但機率極低(連續多次選到極端)。
-
空間:平均 \(\Theta(\log n)\),最壞 \(\Theta(n)\)(遞迴棧)。
-
-
優點:實作簡單、常數小、實務普遍採用。
-
缺點:不提供 worst-case 上界保證。
改進策略二:Median-of-Three(三數取中)
想法:用 \(\text{left}\)、\(\text{middle}\)、\(\text{right}\) 的中位數當 pivot,避免端點成為 pivot。
-
步驟:
-
\(m = \lfloor (l + r)/2 \rfloor\)。
-
取 \(\operatorname{median}(A[l], A[m], A[r])\) 作 pivot(常換到 \(A[r]\))。
-
-
性質:
-
對「接近排序/反向排序」輸入有明顯效果,顯著降低退化概率。
-
平均仍為 \(\Theta(n\log n)\);最壞仍可能 \(\Theta(n^2)\)(可構造反例讓三數取中反覆偏斜)。
-
-
優點:成本低,工程常用(含 introsort 的前段)。
-
缺點:無 worst-case 保證。
改進策略三:Median of Medians(良好 pivot 的保證)
想法:用確定性方法找一個「夠好」的 pivot,使切分至少保持固定比例(例如 \(\ge 30/70\))。
-
經典 5 分組版本(
SELECT演算法):-
將陣列分成每組 \(5\) 個元素,對每組求中位數。
-
對「中位數集合」遞迴求其中位數 \(m^*\)(median of medians)。
-
以 \(m^*\) 當 pivot 做 partition。
-
-
性質:
-
可證明每次切分至少為常數比例 ⇒ QuickSort 的 worst-case 可達 \(\Theta(n\log n)\)。
-
常數大、實作複雜,實務少直接用於排序;更常用於 QuickSelect 提供 \(\Theta(n)\) worst-case。
-
-
優點:提供嚴格 worst-case 上界。
-
缺點:常數與實作成本高,平均效能未必勝過隨機化/三數取中。
tail-recursion elimination
TRE-QUICKSORT(A,p,r):
  while p < r:
    q = PARTITION(A,p,r)
    TRE-QUICKSORT(A,p,q-1)  // 只遞迴左半
    p = q + 1               // 右半改為更新參數→下一圈
- 此為 CLRS 消除 tail-recursion 的方法使用 p=q+1 更新右邊的參數然後每次還是一樣會把右邊之左半邊去做 recursoin 那麼這樣就可以消除 tail-recursion 減少不必要的深度
SMART-QUICKSORT(A,p,r):
  while p < r:
    q = PARTITION(A,p,r)
    if (q - p) < (r - q):
      SMART-QUICKSORT(A,p,q-1)  // 小側
      p = q + 1                 // 大側 → 迴圈
    else:
      SMART-QUICKSORT(A,q+1,r)
      r = q - 1
- 把 stack 的深度降低到 \(O(\log n)\),每次都去找比較小的區域去 recursion 其他交給 while 更新左邊或是右邊
Merge Sort
觀念與策略
-
Merge Sort = 分而治之:對半切、各自排、再合併。
-
Run:已排序片段;每次合併兩個 run 變成更長的 run。
-
Iterative:自底向上,run 長度倍增(1→2→4→8…)。
- 迭代版層次成本:每一層處理 \(n\) 個元素,共 \(\log_2 n\) 層 → \(n\log n\)。
-
Recursive:自頂向下,切到長度 1 再往回合併。
- 時間複雜度:\(T(n) = 2,T\left(\tfrac{n}{2}\right) + cn \quad (n>1),\quad T(1)=\Theta(1) \Rightarrow T(n)=\Theta(n\log n)\)
-
k-way 合併:一次合併 \(k\in{2,4,8,16,\dots}\) 個 run,外部排序常用。
Merge Sort 實作
void merge_sort(int A[], int p, int r) {
    if (p < r) {
        int q = (p + r) / 2;            // 找中間點
        merge_sort(A, p, q);           // 排序左半段
        merge_sort(A, q + 1, r);       // 排序右半段
        merge(A, p, q, r);             // 合併
    }
}

void merge(int A[], int p, int q, int r) {
    int n1 = q - p + 1; // L 的大小
    int n2 = r - q; // M 的大小

    int L[n1], M[n2];
    for (int i = 0; i < n1; i++)
        L[i] = A[p + i];
    for (int j = 0; j < n2; j++)
        M[j] = A[q + 1 + j];

    int i = 0, j = 0, k = p;

    // 合併兩段已排序資料
    while (i < n1 && j < n2) {
        if (L[i] <= M[j])
            A[k++] = L[i++];
        else
            A[k++] = M[j++];
    }

    // 複製剩下的元素
    while (i < n1)
        A[k++] = L[i++];
    while (j < n2)
        A[k++] = M[j++];
}
-
如果
L[i]比M[j]小,就放L[i]然後 i++ 看下一輪會不會還比 M 小,最後可能其中一邊沒放完,就整段放完。 -
合併規則:兩頭比較,小的先放;一邊用完,另一邊整段複製。
Iterative
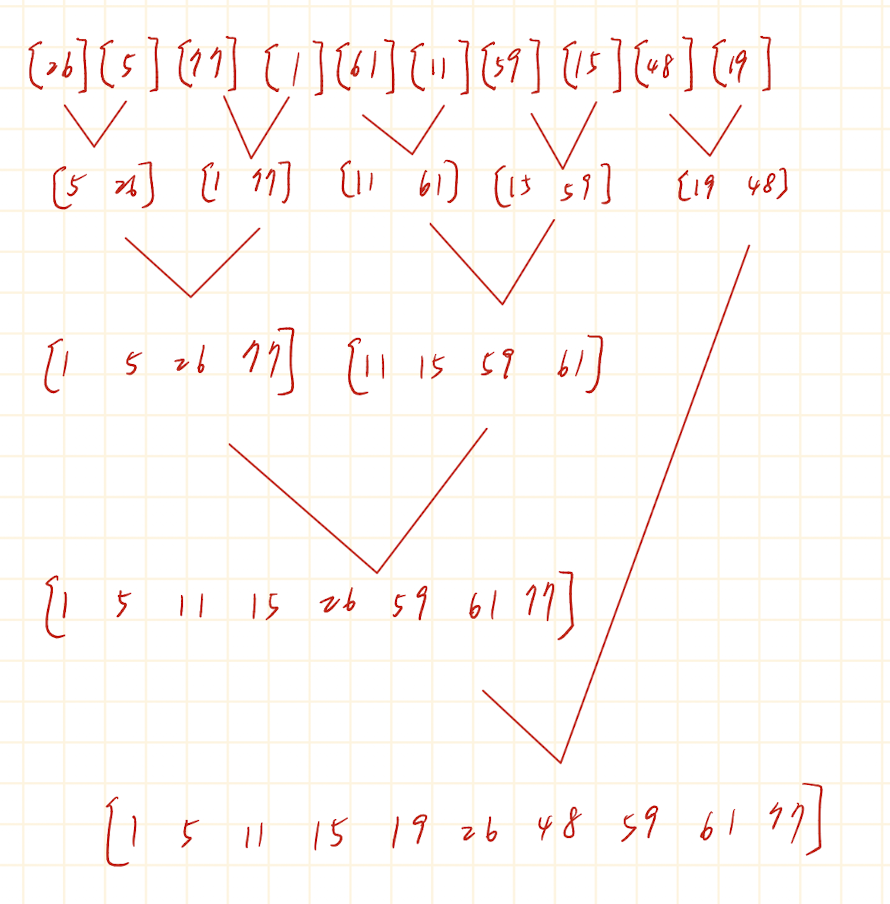
-
先把每個元素都變成一個 run
-
慢慢合併過程有點像一棵二元樹,一回合要花 \(O(n)\) 的時間,那麼因為樹的關係所以跟樹高有關係所以可以從 \(\text{回合數}=\text{樹高}-1 \Rightarrow 2^{i-1} \Rightarrow i=\lceil \log_2 n \rceil + 1 \Rightarrow \lceil \log_2 n \rceil\) 所以最後得 \(O(n \log_2 n)\)
Recursive
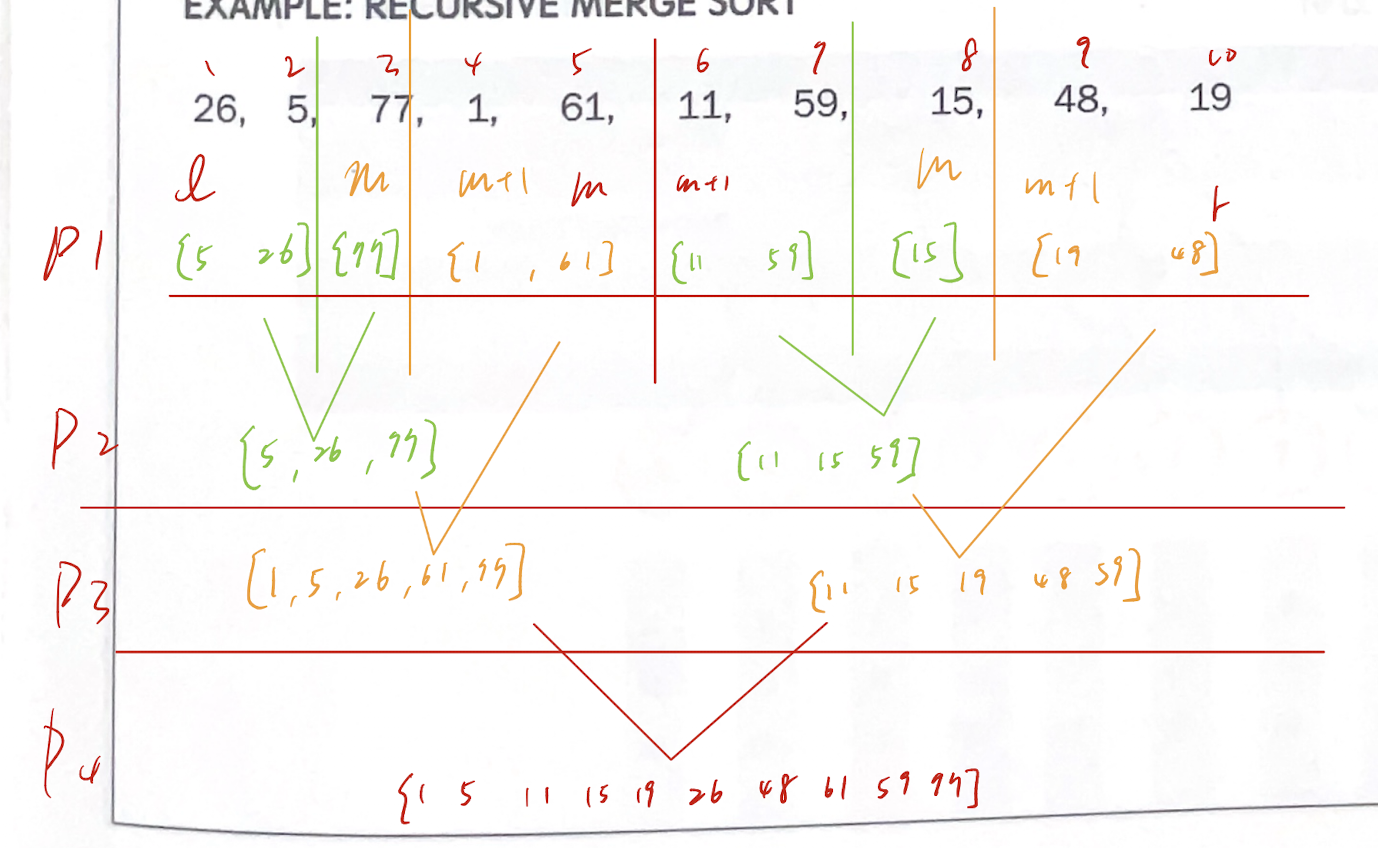
- 那麼每次都切一半,紅色分割是第一次切割,第二次是橘色再來是綠色,接下來因為 if(p<r) 不成立所以就沒有繼續切割然後開始 merge。
複雜度分析
-
資料串列都會被切成 2 等份
-
做右分別執行 merge sort 排序好得到 2 個 runs
-
然後 merge L 和 M 兩個 Runs 或是一個 Run 最少比較 \(n/2\) 次、最多比較 \(n/2+n/2-1=n-1\) 所以可以知道 \(\Theta(n)\),最後與 Quick Sort 的複雜度相同\(T(n)=2T(\tfrac{n}{2})+cn\)
Merge Sort 分析
| 項目 | 內容 |
|---|---|
| 時間複雜度(Best / Worst / Avg) | \(\mathcal{O}(n\log n)\) / \(\mathcal{O}(n\log n)\) / \(\mathcal{O}(n\log n)\) |
| 遞迴式 | \(T(n)=2T(n/2)+c,n,; T(1)=\Theta(1)\) → 解:\(\Theta(n\log n)\) |
| 合併比較次數(兩段 \(n_1,n_2\)) | 最壞:\(n_1+n_2-1\);最好:\(\min(n_1,n_2)\) |
| 空間複雜度 | \(\Theta(n)\)(需暫存陣列;非 in-place) |
| 穩定性 | Stable(合併時使用 <=,相等先取左側保持相對次序) |
| 版本 | Iterative(run 長度倍增 1→2→4→8…)/Recursive(對半切後合併) |
| k-way 合併 | 一次合併 \(k\in{2,4,8,\dots}\) 個 run,外部排序常用 |
Selection Tree 與 External Merge Sort(k-way 合併)
重要概念
-
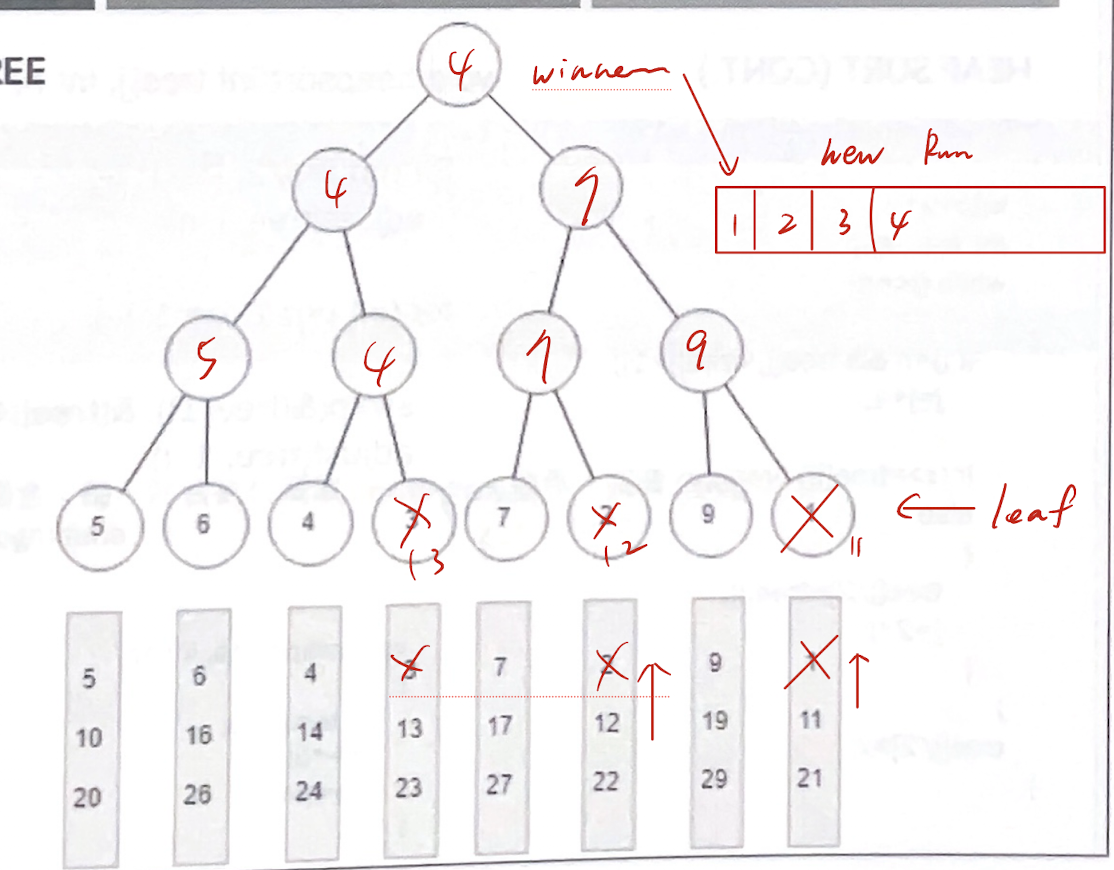
目的:在 k-way 合併 中,以 \(O(\log k)\) 時間選出當前最小鍵並更新,將多個已排序 runs 合併成更長的 new run(外部排序每輪讀 A、寫 B,下一輪讀 B、寫 A),可以想像如果資料是很多個 block 需要合併那麼如果是 external 會存在 disk 裡面那麼需要一直使用 I/O 效率不是很好那麼有沒有一種方法可以把 block merge 成一個大的 block 這就是為什麼需要 Selection Tree。
-
Selection Tree = Tournament Tree(比賽樹),葉節點放各 run 的當前元素;內節點存對賽結果。
-
兩種實作:Winner Tree(內節點存勝者)與 Loser Tree(內節點存敗者,根保留勝者索引)。
-
初始化 \(O(k)\);每次輸出後只需從「該葉→根」一路調整,更新成本 \(O(\log k)\);合併 \(n\) 個元素總比較約 \(\Theta(n\log k)\)。
-
穩定性:相等時固定一側優先(例如左優先),可保穩定。
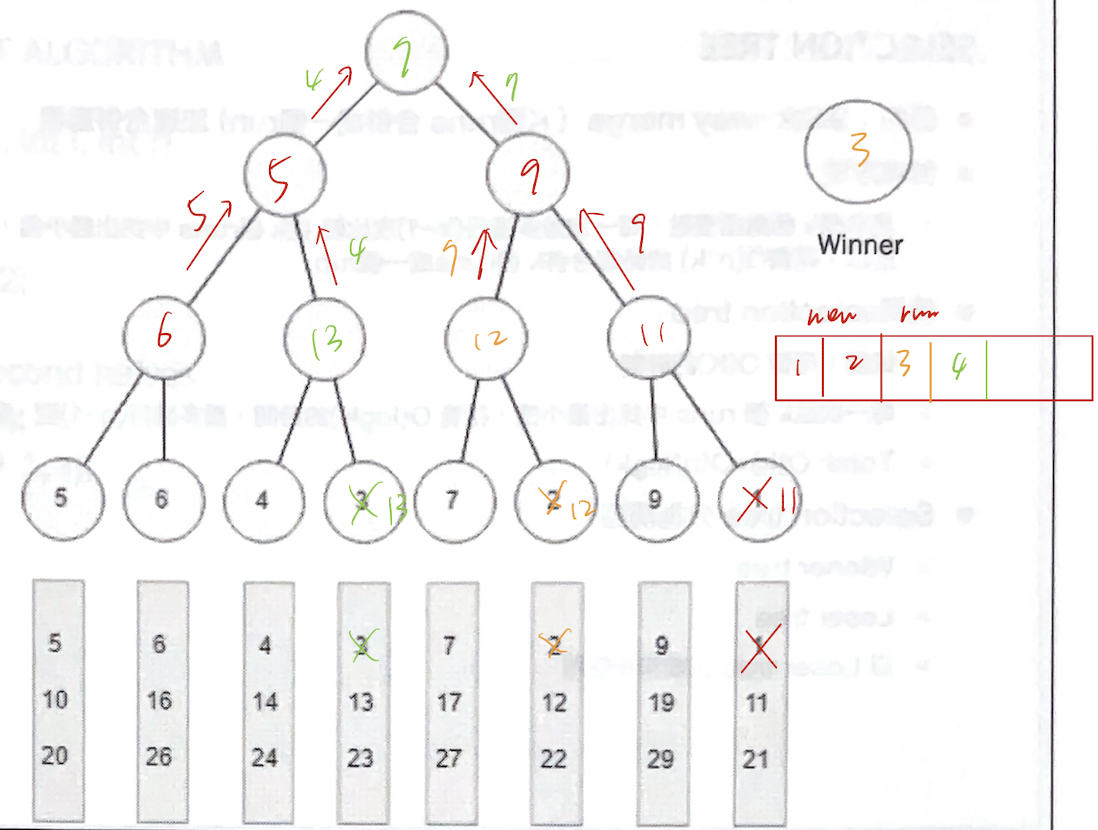
Loser tree
-
結構:內節點記錄較大者(敗者),根保存本輪贏家索引;葉為各 run 的當前鍵。
-
操作:
-
BUILD:自底向上比賽,將敗者寫入父節點,贏家往上;\(O(k)\)。 -
EXTRACT-MIN:讀根對應的鍵,append 到 new run,直到把 runs 全部合併變成 new run。 -
REPLACE & ADJUST:從贏家葉讀下一鍵(或 \(+\infty\)),沿葉→根與節點內敗者重比,更新到根;\(O(\log k)\)。
-
-
優點:更新路徑固定、搬移少,外部排序下的區塊 I/O 親和;實務常用。
Winner tree
-
結構:內節點記錄較小者(勝者),根即全域最小;葉為各 run 的當前鍵。
-
操作與複雜度同 loser tree:輸出根→從該 run 取下一鍵→沿葉→根重比;每次 \(O(\log k)\)。
-
差異:節點存的是勝者,實作細節不同,但時間、空間複雜度相同。
複雜度分析
-
建樹:\(O(k)\),先將 k 個 runs 中的 min-value 複製到 leaf \(O(k)\),然後經過 \(k-1\) 次比較選出 Root \(O(k)\)。
-
每次選最小並更新:\(O(\log k)\),也就是要決定下一輪的 winner 那麼最多會做 \(n-2\) 次找 winner 的動作。
-
合併 \(n\) 個元素:\(O(k) + O(n\log k) = \Theta(n\log k)\)(\(n\gg k\) 時主項)。
-
對比傳統線掃:每步最多比較 \((k-1)\) 次 → \(\Theta(nk)\),當 \(k\gg 1\) 明顯較慢。
-
外部排序整輪:每輪線性掃過全部資料(I/O)+ 內部比較 \(n\log k\),run 數量每輪約除以 \(k\),直到剩 1 條全域有序 run。
證明:k-way merge sort on m runs(總筆數 n)之總時間與 k 無關
-
符號
-
\(n\):資料總筆數
-
\(m\):初始 run 數
-
\(k\):每次同時合併的 run 數(k-way)
-
平均每個 run 長度 \(\approx n/m\)
-
-
單一 group(取 k 個 run 合併一次)**
-
輸出元素數:\(k\cdot(n/m)\)
-
用 selection tree,每輸出一個元素更新成本 \(O(\log k)\)
-
成本:\(O\big(k\cdot \tfrac{n}{m}\cdot \log k\big)\)
-
-
一輪(pass)的成本
-
一輪共有 \(m/k\) 個 group
-
乘上單一 group 成本:\(\frac{m}{k}\times O\Big(k\cdot\frac{n}{m}\cdot\log k\Big) = O(n\log k)\)
-
-
所需輪數
-
每輪把 run 數除以 \(k\),直到從 \(m\) 變 \(1\)
-
輪數 \(=\left\lceil\log_k m\right\rceil\)
-
-
總時間 \[\underbrace{O(n\log k)}*{\text{每輪}}\times\underbrace{\left\lceil\log_k m\right\rceil}*{\text{輪數}} = O\Big(n\times\tfrac{\log m}{\log k}\times \log k\Big) = O(n\log m)\]
結論
-
以比較次數衡量時,總時間 **\(O(n\log m)\),與 \(k\) 無關。
-
但 I/O 輪數 為 \(\left\lceil\log_k m\right\rceil\),與 \(k\) 有關;\(k\) 越大,輪數越少、I/O 越少。
Heap Sort
步驟
-
Create heap:從 \(i=\lfloor n/2\rfloor\) 遞減到 \(1\) 執行下濾。
-
排序:對 \(i=n-1\dots 1\),做 \(\text{swap}(\text{root},\text{pos }i+1)\),再對根執行下濾到大小 \(i\) 的堆。
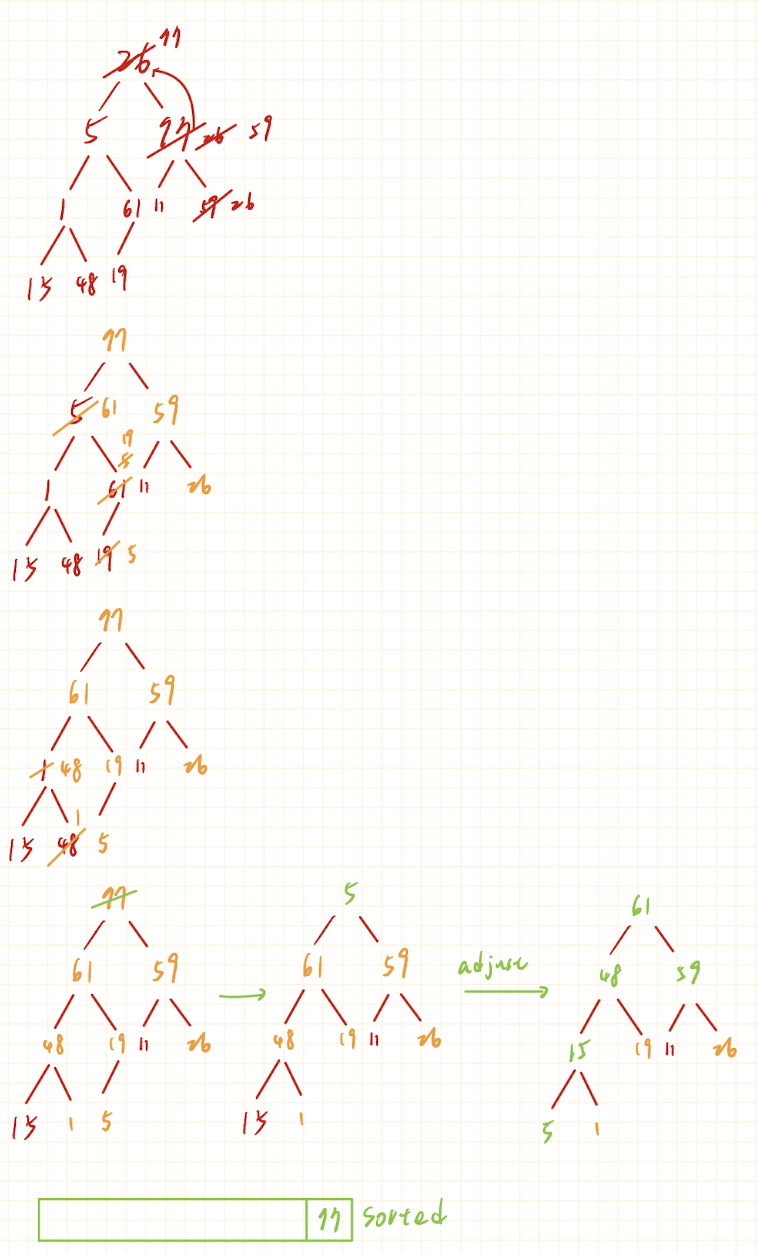
建堆與排序流程(程式區塊)
// sift-down:把 tree[i] 往下調成最大堆(1-based 思維,n=heap size)
void adjust(int tree[], int i, int n) {
    int j = 2 * i;      // left child
    int x = tree[i];    // 暫存根值
    while (j <= n) {
        if (j < n && tree[j] < tree[j + 1]) j++; // 選較大的子
        if (x >= tree[j]) break;                 // 已符合堆
        tree[i] = tree[j];                       // 子上移
        i = j;
        j = 2 * j;
    }
    tree[i] = x; // x 落位
}

void heapsort(int tree[], int n) {
    // I) bottom-up 建立最大堆:O(n)
    for (int i = n / 2; i >= 1; --i)
        adjust(tree, i, n);

    // II) 排序回合:n-1 次,每次 O(log n) → 總 O(n log n)
    for (int i = n - 1; i >= 1; --i) {
        swap(&tree[1], &tree[i + 1]); // 根(最大) ↔ 當前尾
        adjust(tree, 1, i);           // 對縮小後的堆下濾
    }
}

void swap(int *a, int *b) { int t = *a; *a = *b; *b = t; }
複雜度與性質
-
建堆:bottom-up
heapify,時間 \(\mathcal{O}(n)\),空間 \(\mathcal{O}(1)\)。 -
排序階段:執行 \(n-1\) 次 delete-max:每回合 \(\mathcal{O}(\log n)\);總 \(\mathcal{O}(n\log n)\)。
-
整體:
-
時間:Best/Worst/Avg 皆 \(\mathcal{O}(n\log n)\)。
-
空間:\(\mathcal{O}(1)\)(in-place)。
-
穩定性:Unstable。
-
排序演算法的理論極限與分類
-
在限定使用 comparison-based 或是 swap 技巧下,最快可以達到 \(\Omega(n \log n)\)。
-
如果不是採用此排序技巧,則不受此限制,也就是有可能來到 linear-time: \(O(n)\) 的排序時間,也就是 LSD Radix Sort 和 MSD Radix Sort (Bucket Sort)、Counting Sort。
Decision tree
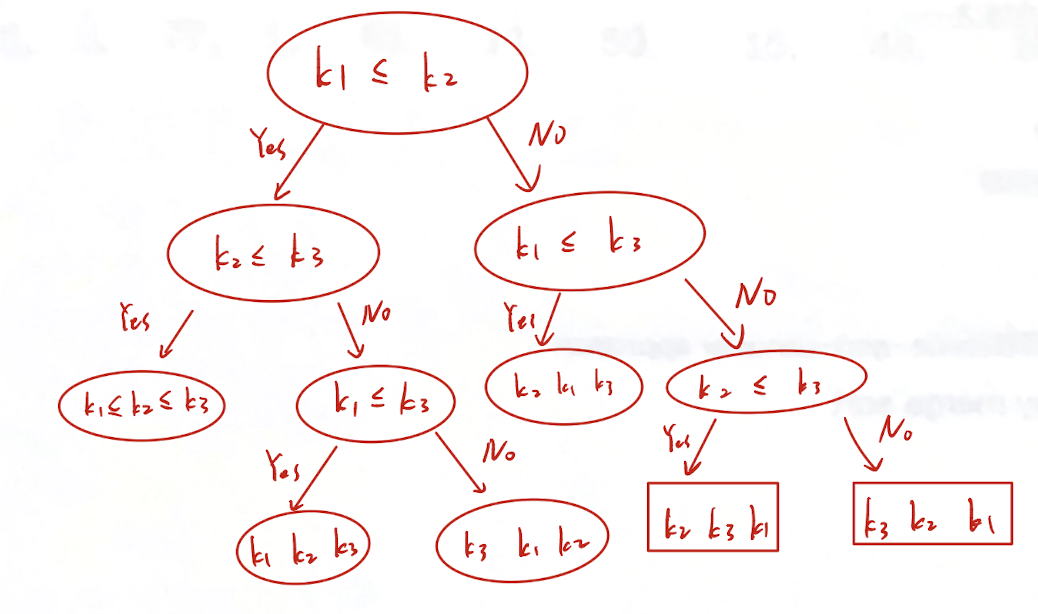
Decision tree for sorting comparison behavior,使用三個資料 \(K_1,K_2,K_3\) 排序之 Decision tree。
-
Non-leaf ⇒ Compare node 內部節點表示一次元素間的大小比較。
-
Leaf ⇒ 某個 sorted 結果 葉節點對應一個最終排序結果(輸出排列)。
-
It is Binary Tree 每次比較只有兩種結果(≤、>),因此模型是二元樹。
-
n 個資料排序 ⇒ n! 種可能結果 需能區分所有排列,故決策樹至少需要 \(n!\) 個葉節點。
-
比較次數下限 = B.T. height − 1(Root level = 1) 若樹高為 \(h\),最壞情況比較次數為 \(h-1\);且二元樹 \(2^h \ge n! \Rightarrow h \ge \log_2(n!) = \Theta(n\log n)\)。
Proof
命題:在僅使用比較(comparison-based)的模型中,排序 \(n\) 筆互異資料的最壞比較次數下限為 \(\Omega(n\log n)\)。
思路
-
\(n\) 筆資料的排序結果有 \(n!\) 種可能。
-
任何比較式排序可視為一棵二元決策樹:
-
內部節點\(\Rightarrow\)一次比較;
-
葉節點\(\Rightarrow\)一個最終輸出排列;
-
故葉節點數 \(\ge n!\)。
-
樹高推導
令決策樹高度為 \(h\)(root level = 1)。
-
二元樹的葉節點數上界:\(\text{leaves} \le 2^{h-1}\)(或取常見簡化 \(\le 2^{h}\),不影響 \(\Theta\) 結論)。
-
需容納 \(n!\) 個葉:\(2^{h} \ge n!\)。
-
取對數:\(h \ge \lceil \log_2(n!) \rceil\)。
最壞比較次數 \(\ge h-1 \ge \lceil \log_2(n!) \rceil - 1\)。
近似化簡(史特林)
用斯特林近似 \(\log_2(n!) = \Theta(n\log n)\),因此
\[\text{Worst-Case Comparisons} \ge c \cdot n\log n = \Omega(n\log n).\]
小例題
Ex. 以比較法排序 5 筆資料,最壞比較次數下限約是多少?
- \(\lceil \log_2(5!) \rceil = \lceil \log_2 120 \rceil = 7\)。
因此任何比較式排序在最壞情況至少需要 7 次比較。