Selection Problem
Selection Problem的重點整理。
定義和問題
-
問題描述:在未排序陣列 \(A\)(含 \(n\) 個互異元素)中,找出第 \(k\) 小的元素,\(1 \le k \le n\)
-
輸入:\(A\)、\(k\)
-
輸出:\(A\) 的第 \(k\) 小元素
-
特例:
-
最小值:\(k=1\)
-
最大值:\(k=n\)
-
中位數:\(k \approx \frac{n}{2}\)(較能抵抗極端值)
-
-
核心問題:能否在不完整排序下,比排序更快地找到第 \(k\) 小元素
-
基線解:排序 \(A\) 需 \(\mathcal{O}(n\log n)\),取第 \(k\) 個為 \(\mathcal{O}(1)\),總計 \(\mathcal{O}(n\log n)\)
-
為何可更快:
-
比較模型中,排序下限 \(\Omega(n\log n)\)
-
選擇問題嚴格更容易,可望低於 \(\mathcal{O}(n\log n)\)
-
目標:線性時間 \(\mathcal{O}(n)\)(至少需讀過每個元素一次)
-
-
設計要點:分割與遞迴(divide and conquer),只做與序位相關的部分工作,避免完整排序
方法
方法 1|同時計算最小與最大值(Pairwise 成對法)
-
問題定義:給定長度 \(n\) 的陣列 \(A\),同時計算 \(\min(A)\) 與 \(\max(A)\),使比較次數最少
-
經典天真法(對照):
-
分別線性掃描兩次:\((n-1)\) 次求 \(\min\),再 \((n-1)\) 次求 \(\max\)
-
比較次數:\(2n-2\)
-
-
成對法(最佳):
-
核心:兩兩成對。先在對內比較一次,較小者只與 \(min\) 比,較大者只與 \(max\) 比
-
演算法:
-
初始化:
-
\(n\) 為奇數:\(min = max = A[0]\),從索引 \(1\) 起成對
-
\(n\) 為偶數:先比 \(A[0]\) 與 \(A[1]\)( 次);小者給 \(min\),大者給 \(max\),從索引 \(2\) 起成對
-
-
成對處理:每對 \((x,y)\)
-
先比 \(x\) 對 \(y\)(\(1\) 次)
-
較小者對 \(min\)(\(1\) 次);較大者對 \(max\)(\(1\) 次)
-
每對固定 \(3\) 次比較
-
-
掃描結束輸出 \((min,;max)\)
-
-
-
比較次數分析:
-
\(n\) 為偶數:\(1 + 3\Big(\frac{n}{2}-1\Big) = \frac{3n}{2}-2\)
-
\(n\) 為奇數:\(3\Big\lfloor \frac{n}{2} \Big\rfloor\)
-
統一上界:\(\le 3\Big\lfloor \frac{n}{2} \Big\rfloor\)
-
-
最優性(下界):
-
對抗者或決策樹可證:同時計算 \(\min,\max\) 至少需 \(\lceil 3n/2 \rceil - 2\) 次比較
-
成對法達到該下界,於比較模型中最優
-
-
正確性不變量:
-
任一時刻,
min為已處理元素之最小值,max為最大值 -
對內先比較保證只把「較小者」拿去與 \(min\) 比、「較大者」拿去與 \(max\) 比
-
-
pseudocode:
PAIRWISE-MIN-MAX(A)
  n ← length(A)
  if n == 1: return (A[0], A[0])
  if n is even:
    if A[0] < A[1]: min ← A[0]; max ← A[1]
    else:           min ← A[1]; max ← A[0]
    i ← 2
  else:
    min ← A[0]; max ← A[0]
    i ← 1
  while i ≤ n-2:
    x ← A[i]; y ← A[i+1]
    if x < y:
      if x < min: min ← x
      if y > max: max ← y
    else:
      if y < min: min ← y
      if x > max: max ← x
    i ← i + 2
  return (min, max)
方法 2|Randomized-Select
-
命名核心:每次遞迴都隨機選 pivot。隨機性不是實作細節,而是演算法本質,並且使用 quick sort 裡面的類似 partition 方法,因為 pivot 是隨機。
-
與確定性法的區別:
- Randomized-Select:隨機等機率選 pivot。放棄最壞情況保證,換得簡單與平均表現。
-
效能模型由隨機性決定:
-
最壞情況:若連續選到極端 pivot,時間 \(O(n^2)\)。
-
期望情況:有約 \(1/2\) 機率選到「好 pivot」,使規模 \(\le \tfrac{3}{4}n\);平均僅需約兩次即可遇到好 pivot,整體期望時間 \(O(n)\)。
-
-
實務優勢:
-
簡單:實作容易。
-
常數小:較少額外結構與計算,實測常快於 Median of Medians。
-
-
關鍵遞迴細節:
-
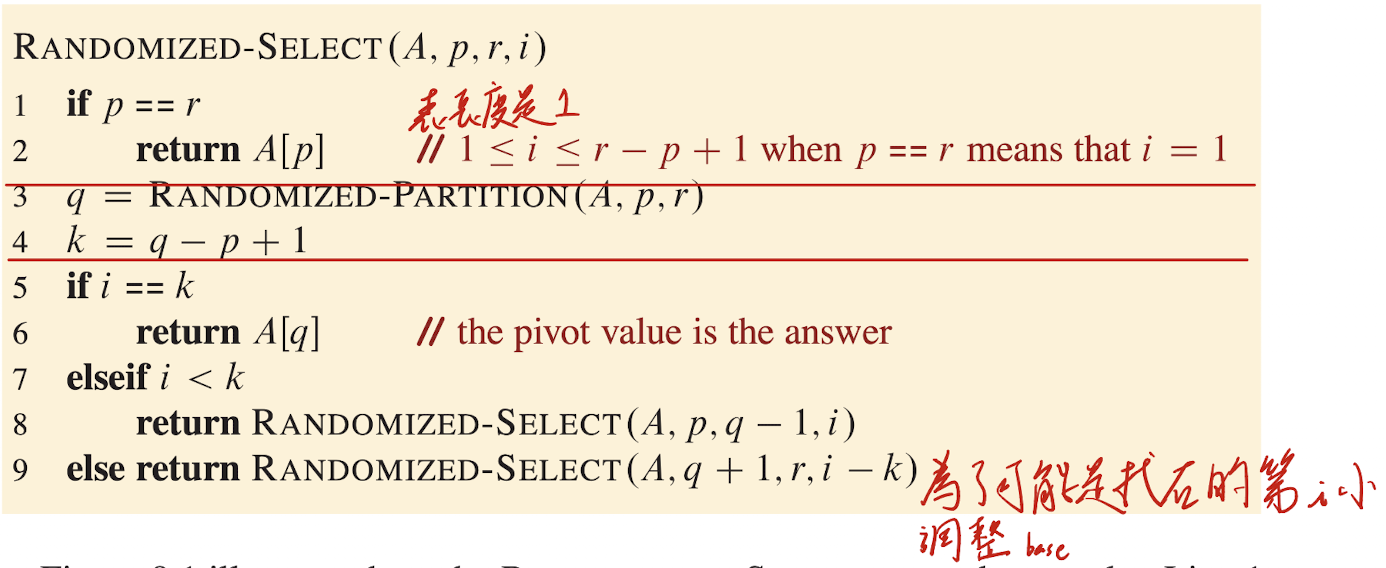
基底情況:若 \(p=r\),子陣列 \(A[p..r]\) 僅一元素,其秩為 \(1\),直接回傳 \(A[p]\)。
-
秩調整 \(i-k\):令 \(q\) 為 pivot 位置,\(k=q-p+1\) 為 pivot 在 \(A[p..r]\) 的秩。
-
若 \(i<k\):在左半 \(A[p..q-1]\) 找第 \(i\) 小。
-
若 \(i=k\):回傳 \(A[q]\)。
-
若 \(i>k\):在右半 \(A[q+1..r]\) 找第 \(i' = i-k\) 小(因左半含 pivot 的 \(k\) 個元素皆 \(\le\) pivot,已被排除)。
-
迷你例:原目標第 \(i=7\) 小,pivot 秩 \(k=4\),改在右半找第 \(i'=7-4=3\) 小。
-
-
Randomized-Select 分析
-
最佳情況(Best Case)
-
條件:每次 pivot 使目標落在另一側大小 \(\le n/2\) 的子陣列(如接近中位)
-
遞迴式:\[T(n)=T\left(\tfrac{n}{2}\right)+cn\]
-
解(Master 定理 Case 3):\[T(n)=\Theta(n)\]
-
直覺:每層 \(O(n)\) 做一次 partition,規模對半,幾何級數收斂為線性
-
-
最差情況(Worst Case)
-
條件:每次 pivot 為最小或最大,只去掉 \(1\) 個元素
-
遞迴式:\[T(n)=T(n-1)+cn\]
-
展開:
-
- **對照**:與 Quicksort 最壞遞迴同型,每層線性,層數近 $n$
-
期望情況(Expected / Average Case)
-
隨機化機制:每次
PARTITION的 pivot 由均勻亂數選出;對固定輸入,時間為隨機變數 \(T(n)\),求 \(\mathbb{E}[T(n)]\) -
關鍵引理(CLRS 9.1):
-
定義「有幫助」切分:保留的子問題大小 \(\le \tfrac{3}{4}\) 上一次
-
當 pivot 落在中間一半(秩在 \(\lceil n/4\rceil,\lfloor 3n/4\rfloor\))即為有幫助
-
機率界:落在中間一半的機率 \(\ge \tfrac{1}{2}\),平均約兩次切分就遇到一次有幫助
-
-
幾何衰減計數:
-
以「世代」為單位:兩次有幫助切分之間的切分群
-
第 \(k\) 世代規模 \(n_k\le (3/4)^k n\)
-
每次切分成本 \(\le c,n_k\)
-
-
期望總成本上界:
-
    - CLRS 常數上界約 $<8n$;配合首層的 $\Omega(n)$,得 $\Theta(n)$

- **結論**:$$\boxed{\ \mathbb{E}[T(n)]=\Theta(n)\ }$$
方法3|Median of Medians
-
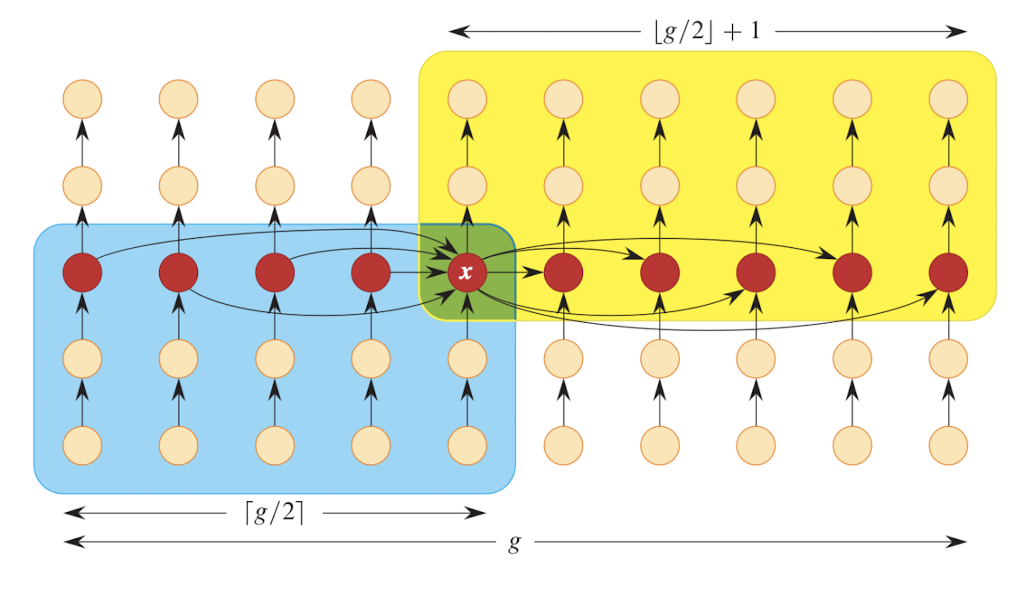
目的在於提供一個 method 可以在 worst case 的時候還是 \(O(n)\) 。
-
那他的方式或是原則就是小心選擇 pivot。
實現方法
-
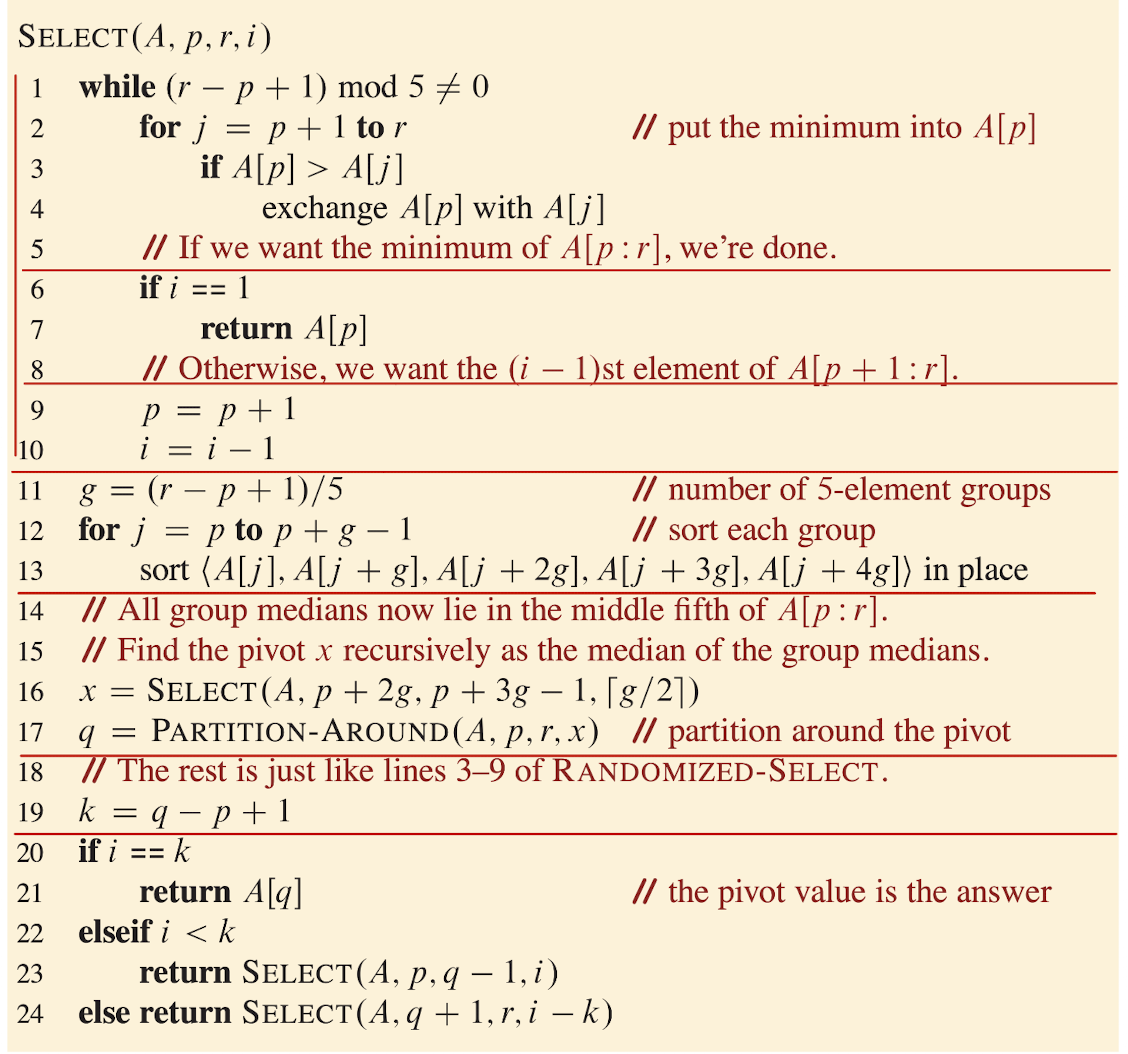
1. 分組:把當前子陣列切成 \(5\) 人小組;最後一組可不足 \(5\)。一次線性掃描完成,\(O(n)\),並且把 \(p+1\) 往後因為最前面已經是最小的那幾個了所以 \(i-1\)
-
2. 組內排序:對每組 \(5\) 個做就地排序(常用 insertion sort)。每組成本為常數,組數 \(\lceil n/5\rceil\),合計 \(O(n)\),順便計算有幾組 11 行,12~13 就是把 group 排序
-
3. 取得 median-of-medians 並分割:
-
設有效長度為 \(n'\),組數 \(g=\frac{n'}{5}\)。各組中位數收集成連續切片 \(A[p+2g,..,p+3g-1]\)(長度 \(g\))
-
在此切片上遞迴呼叫
SELECT取其中位數 \(x\)(注意:不是因為已排序,而是對該切片做遞迴選取) -
以值 \(x\) 對整段 \(A[p..r]\) 做
partition,得位置 \(q\)
-
-
4. 判斷方向:令 \(k=q-p+1\)
-
若 \(i=k\):回傳 \(x\)
-
若 \(i<k\):只在左側遞迴
-
若 \(i>k\):只在右側遞迴,秩改為 \(i-k\)
-
-
要點:
-
每次進入
SELECT都會重新分組與小排序(子問題範圍已改) -
若長度非 \(5\) 的倍數,可先剝掉至多 \(4\) 個最小值(同步更新 \(p\leftarrow p+1,\ i\leftarrow i-1\))
-
最壞情況複雜度遞迴:
\[T(n)\ \le\ T\left(\left\lceil \tfrac{n}{5}\right\rceil\right)\ +\ T\left(\tfrac{7n}{10}+O(1)\right)\ +\ O(n)\ =\ O(n).\]
-
證明
-
以 \(5\) 人一組並組內排序,取每組中位形成集合 \(M\),令 \(x=\mathrm{median}(M)\)。
-
依定義,\(M\) 中至少一半的組中位 \(\ge x\)(與遞迴方向無關)。
-
在每個這類「好組」中,因已排序,至少 3 個元素 \(\ge x\)(組中位本身及其右側兩個)。
-
需扣除至多 2 組 的例外:包含 \(x\) 的那組,以及可能不足 \(5\) 個元素的殘缺組。
-
因此,\(\ge x\) 的元素數至少
對稱地,$\le x$ 的元素數也至少 $\tfrac{3n}{10}-O(1)$。
- 於是以 \(x\) 分割後,仍需遞迴的較大一側大小
- 導出最壞情況遞迴式
Total complex Time
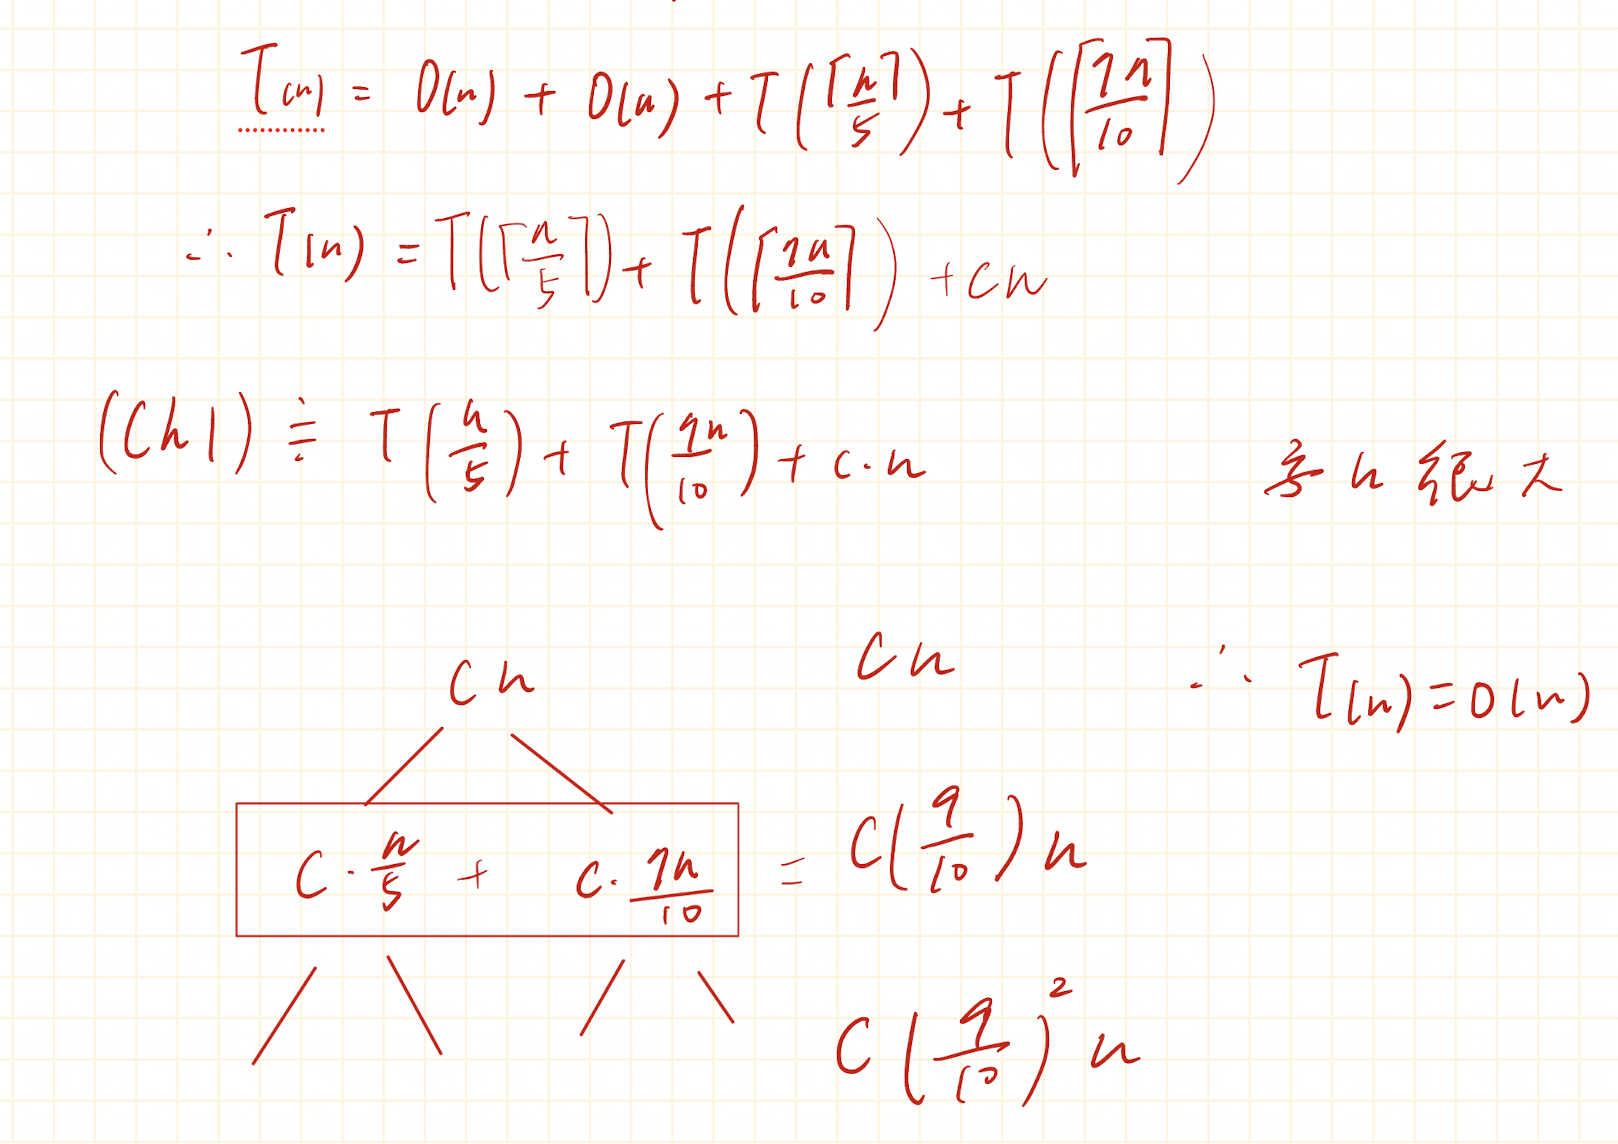
範例
-
資料:\(A[p..r]=[22,7,18,11,25,9,14,6,20,13]\);\(p=0\),\(n=10=5g\Rightarrow g=2\)
-
1) 分組+組內排序(就地)(\(j=0,1\))
-
組1:索引 \([j,j+g,j+2g,j+3g,j+4g]=[0,2,4,6,8]\)
值 \([22,18,25,14,20]\ \rightarrow\) 排序寫回 \(\rightarrow\ [14,18,20,22,25]\)
組中位索引 \(0+2g=4\),值 \(20\) -
組2:索引 \([1,3,5,7,9]\)
值 \([7,11,9,6,13]\ \rightarrow\) 排序寫回 \(\rightarrow\ [6,7,9,11,13]\)
組中位索引 \(1+2g=5\),值 \(9\) -
此時整段:\([14,6,18,7,20,9,22,11,25,13]\)
-
所有組中位數切片:\(A[p+2g..p+3g-1]=A[4..5]=[20,9]\)(長度 \(g=2\))
-
-
2) 在「組中位數切片」上取中位
-
呼叫
SELECT(A, 4, 5, ⌈g/2⌉=1) -
得 \(x=9\)(median-of-medians)
-
-
3) 以 \(x\) 分割整段
-
PARTITION-AROUND(A, 0, 9, x=9),把陣列切為「\(\le 9\) | \(\ge 9\)」,並將 \(x\) 放至正確位置 \(q\) -
這裡 \(\le 9\) 元素為 \({6,7,9}\),故 \(k=q-p+1=3\)
-
一種可能結果:\([6,7,9,14,20,18,22,11,25,13]\) 且 \(q=2\)
-
-
4) 決定遞迴方向(欲找第 \(i\) 小)
-
\(i=3\):命中,答案 \(9\)
-
\(i<3\):往左子陣列 \(A[0..1]\)
-
\(i>3\):往右子陣列 \(A[3..9]\),改找第 \(i-3\) 小
-