LCS vs. Minimum Edit Distance
LCS vs. Minimum Edit Distance的重點整理。
核心差異總覽 (Core Differences)
| 特性 | 最長公共子序列 (LCS) | Minimum Edit Distance |
|---|---|---|
| 目的 | 找出 \(S_1\) 與 \(S_2\) 的最長共同子序列 | 將 \(S_1\) 轉換為 \(S_2\) |
| 提問 | 我們有多像? | 變成相同要多少工? |
| 目標 | 最大化 共同長度 | 最小化 操作成本 |
| 關鍵操作 | 匹配、跳過 | 匹配、插入、刪除、替換 |
| 公式核心 | max() |
min() |
1. 最長公共子序列 (LCS)
A. 問題定義
給定兩序列 \(X=\langle x_1,\dots,x_m\rangle\) 與 \(Y=\langle y_1,\dots,y_n\rangle\),找 \(X\) 與 \(Y\) 的最長共同子序列。
子序列:刪除若干元素且不改變相對順序所得,如 “ace” 為 “abcde” 之子序列,“aec” 不是。
B. 結構、狀態與轉移
1. 最優解的結構 (Optimal Substructure)
這是推導 DP 公式最關鍵的一步。我們想找出 \(X_m\) ( \(X\) 的所有字元) 和 \(Y_n\) ( \(Y\) 的所有字元) 之間的 LCS,我們只需要比較最後一個字元:\(x_m\) 和 \(y_n\)。
-
Case 1: \(x_m = y_n\) (最後一個字元相同)
-
結論: 這個字元 (\(x_m = y_n\)) 必定是 LCS 的最後一個字元。我們剩下的任務就是去找出 \(X\) 的前面 \(m-1\) 個字元 (\(X_{m-1}\)) 和 \(Y\) 的前面 \(n-1\) 個字元 (\(Y_{n-1}\)) 之間的 LCS。
-
LCS(\(X_m, Y_n\)) = LCS(\(X_{m-1}, Y_{n-1}\)) + \(x_m\)
-
-
Case 2: \(x_m \ne y_n\) (最後一個字元不同)
-
結論: \(x_m\) 和 \(y_n\) 不可能同時是 LCS 的最後一個字元。LCS 必定藏在以下兩種可能之中:
-
LCS(\(X_{m-1}, Y_n\)) (把 \(x_m\) 丟掉)
-
LCS(\(X_m, Y_{n-1}\)) (把 \(y_n\) 丟掉)
-
-
我們取兩者中較長 (Max) 的那個。
-
LCS(\(X_m, Y_n\)) = Max( LCS(\(X_{m-1}, Y_n\)), LCS(\(X_m, Y_{n-1}\)) )
-
2. 狀態與轉移方程
基於上述結構,我們定義狀態並建立遞迴解:
狀態: c[i, j] 為 \(X\) 前 \(i\) 與 \(Y\) 前 \(j\) 的 LCS 長度。
轉移:
\[c[i,j]= \begin{cases} 0 & i=0 \text{ 或 } j=0\\ c[i-1,j-1]+1 & X_i=Y_j \text{ (對應 Case 1)}\\ \max{(c[i-1,j],c[i,j-1])} & X_i\ne Y_j \text{ (對應 Case 2)} \end{cases}\]
邊界: \(c[i,0]=0,c[0,j]=0\)。
C. 演算法 (Bottom-Up)
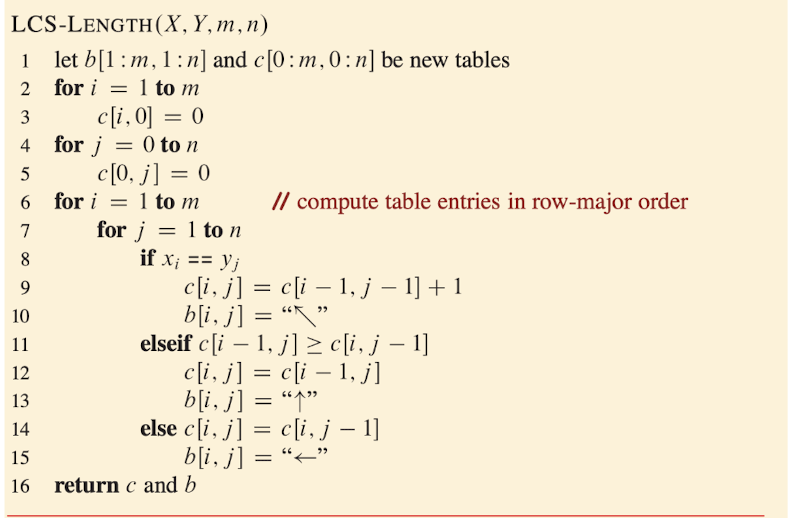
如果直接用遞迴公式,會因為「重疊子問題」導致效率極低。因此我們用 DP (Bottom-Up),開一個 c[0..m, 0..n] 表格,從 c[0, 0] 開始,一格一格把答案算出來,直到 c[m, n]。
LCS-LENGTH 產生 c(長度)與 b(方向)自上而下、左到右填表。
D. 範例
口訣:一樣斜上,大看上,小看左,記得要加 1。
\(X=\langle A,B,C,B,D,A,B\rangle;(m=7)\)
\(Y=\langle B,D,C,A,B,A\rangle;(n=6)\)
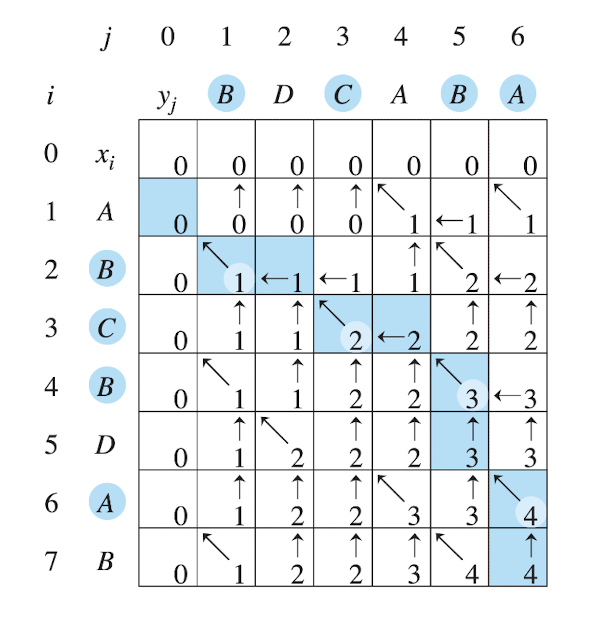
最終長度:c[7,6]=4;其中一個 LCS:“BCBA”。
E. 回溯 (Reconstruction)
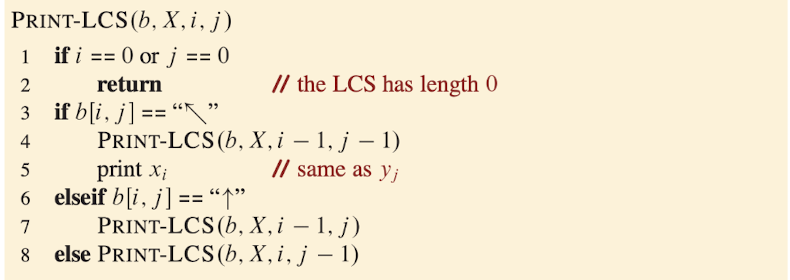
c 表格只告訴我們「長度」,b 表格 (存箭頭 ↖, ↑, ←) 才是用來回溯找出「LCS 到底長怎樣」的。PRINT-LCS 自右下 b[m,n] 依箭頭回溯。
-
如果箭頭是
↖:代表 \(X_i\) 是一個匹配,它是 LCS 的一部分。我們把它印出來 (或記錄下來),然後跳到b[i-1, j-1]繼續找。 -
如果箭頭是
↑:代表 \(X_i\) 被跳過了。我們不印東西,跳到b[i-1, j]繼續找。 -
如果箭頭是
←:代表 \(Y_j\) 被跳過了。我們不印東西,跳到b[i, j-1]繼續找。 -
直到
i=0或j=0為止。
F. 複雜度分析 (Complexity)
-
時間複雜度 (Time):
-
LCS-LENGTH演算法的核心是兩個for迴圈 (一個i從 1 到 \(m\),一個j從 1 到 \(n\))。 -
迴圈中的每一步(填
c[i, j]和b[i, j])都只花了 \(O(1)\) 常數時間。 -
總時間複雜度:\(\Theta(mn)\)
-
-
空間複雜度 (Space):
-
我們需要儲存
c表格 (大小 \((m+1) \times (n+1)\)) 和b表格 (大小 \(m \times n\))。 -
總空間複雜度:\(\Theta(mn)\)
-
(優化:如果「不」需要
b表格來回溯,只要求「長度」,空間可以優化到 \(\Theta(\min(m, n))\) )
-
-
回溯時間 (Reconstruction Time):
-
PRINT-LCS函式從(m, n)開始,每一步遞迴i或j(或兩者) 都會減 1。 -
路徑的總長度最多是 \(m + n\)。
-
回溯時間複雜度:\(O(m+n)\)
-
2. Minimum Edit Distance
A. 定義
給定 \(S_1\)(長度 \(m\))與 \(S_2\)(長度 \(n\)),求將 \(S_1\) 轉換為 \(S_2\) 的最小操作數。允許操作成本皆為 \(1\):Insert、Delete、Replace。
B. 狀態與轉移
狀態: dp[i, j] 為將 \(S_1[1..i]\) 轉為 \(S_2[1..j]\) 的最小成本。
轉移:
\[dp[i, j] = \min \begin{cases} dp[i-1, j] + 1 & \text{(刪除 $S_1[i]$)} \\ dp[i, j-1] + 1 & \text{(插入 $S_2[j]$)} \\ dp[i-1, j-1] + \text{cost} & \text{(匹配/替換)} \end{cases}\]
其中 \(\text{cost}=0\) 若 \(S_1[i]=S_2[j]\),否則 \(\text{cost}=1\)。
邊界: \(dp[0,0]=0,;dp[i,0]=i,;dp[0,j]=j\)。
C. 演算法
-
建立
dp[0..m,0..n]。 -
填第一列與第一行。
-
雙迴圈計算三方向成本取最小。
-
回傳
dp[m,n]。
程式碼片段
EDIT-DISTANCE(S1, S2)
  m = length(S1)
  n = length(S2)
  let dp[0..m, 0..n] be a new table

  // 1. Initialize Base Cases (Boundaries)
  for i = 0 to m
    dp[i, 0] = i  // Deletion cost
  for j = 1 to n
    dp[0, j] = j  // Insertion cost

  // 2. Fill the table
  for i = 1 to m
    for j = 1 to n
      // Calculate substitution/match cost
      if S1[i] == S2[j]
        sub_cost = 0
      else
        sub_cost = 1

      // 3. Calculate costs from three directions
      cost_del = dp[i - 1, j] + 1
      cost_ins = dp[i, j - 1] + 1
      cost_match_replace = dp[i - 1, j - 1] + sub_cost

      // 4. Take the minimum
      dp[i, j] = min(cost_del, cost_ins, cost_match_replace)持ㄕ

  // 5. Return final cost
  return dp[m, n]
D. 範例
\(S_1=\text{"SAT"}\), \(S_2=\text{"CAT"}\)
      j   0 ("")     1 ("C")      2 ("A")     3 ("T")
i
0 ("")  ( 0, - )     ( 1, ← )     ( 2, ← )     ( 3, ← )
1 ("S") ( 1, ↑ )     ( 1, ↖ )     ( 2, ← )     ( 3, ← )
2 ("A") ( 2, ↑ )     ( 2, ↑ )     ( 1, ↖ )     ( 2, ← )
3 ("T") ( 3, ↑ )     ( 3, ↑ )     ( 2, ↑ )     ( 1, ↖ )
最終答案:dp[3,3]=1。
E. 回溯 (Reconstruction)
dp 表格和箭頭不僅能給出最小成本,還能回溯出具體的操作步驟。
從 \(dp[m, n]\) (右下角) 開始,跟隨箭頭回溯到 \(dp[0, 0]\) (左上角):
-
↖(來自左上):-
如果
cost = 0(即 \(S_1[i] = S_2[j]\)),代表 匹配 (Match)。 -
如果
cost = 1(即 \(S_1[i] \ne S_2[j]\)),代表 替換 (Replace)。
-
-
↑(來自上面):代表 刪除 (Delete) \(S_1[i]\)。 -
←(來自左邊):代表 插入 (Insert) \(S_2[j]\)。
範例 “SAT” \(\to\) “CAT” 回溯:
-
dp[3, 3](1,↖):來自dp[2, 2],‘T’ == ‘T’,匹配 ‘T’。 -
dp[2, 2](1,↖):來自dp[1, 1],‘A’ == ‘A’,匹配 ‘A’。 -
dp[1, 1](1,↖):來自dp[0, 0],‘S’ != ‘C’,替換 ‘S’ \(\to\) ‘C’。 -
dp[0, 0]:到達起點,結束。
總操作: 1 次「替換」。
F. 複雜度分析 (Complexity)
-
時間複雜度 (Time):
-
演算法的核心是兩個
for迴圈 ( \(i\) from 1 to \(m\), \(j\) from 1 to \(n\))。 -
在迴圈中,我們只執行 \(O(1)\) 的常數時間操作 (三次查表、一次
min運算)。 -
總時間複雜度:\(\Theta(mn)\)
-
-
空間複雜度 (Space):
-
我們需要儲存
dp表格,其大小為 \((m+1) \times (n+1)\)。 -
總空間複雜度:\(\Theta(mn)\)
-
(優化:如果只要求「最小成本」而不需回溯「操作路徑」,空間可以優化到 \(\Theta(\min(m, n))\),因為計算第 \(i\) 列時,我們只需要第 \(i-1\) 列的資訊。)
-
-
回溯時間 (Reconstruction Time):
-
回溯是從
(m, n)走回(0, 0)。 -
每一步 \(i\) 或 \(j\) (或兩者) 都會減 1。
-
路徑的總長度最多是 \(m + n\)。
-
回溯時間複雜度:\(O(m+n)\)
-