互斥集合 (Disjoint Sets)
互斥集合 (Disjoint Sets)的重點整理。
📘 Disjoint Set - Abstract Data Type (ADT)
Disjoint Set 是一種管理不相交集合(disjoint sets)的資料結構,支援以下三個基本操作:
🔧 操作定義:
-
Make-Set(x)
建立一個新的集合,僅包含元素 \(x\) -
Find-Set(x)
回傳包含元素 \(x\) 的集合的代表元素(root) -
Union(x, y)
合併包含 \(x\) 和 \(y\) 的兩個集合為一個集合
-
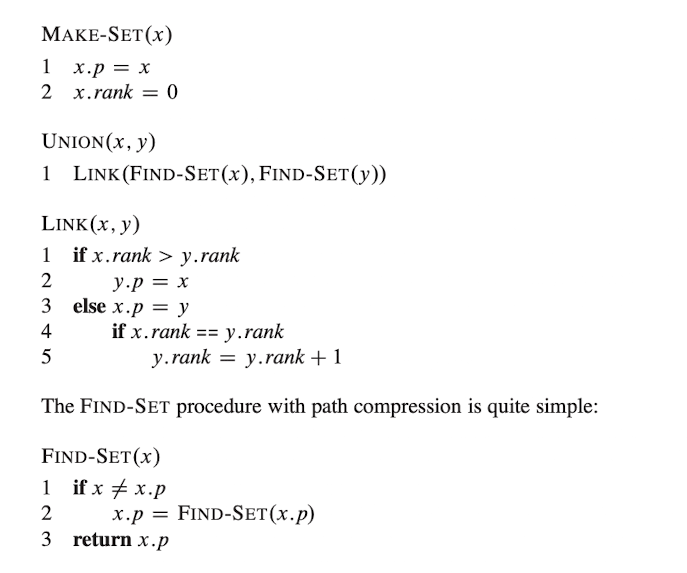
以下是 CLRS 的虛擬碼
🏗️ Disjoint Set Representation(表示法)
🧷 1. Linked List 表示法
📌 結構概念:
-
每個集合是一個 Linked List
-
每個節點包含兩個欄位:
-
資料值(data)
-
和 parent 的指標,也就是說其他的 data 都會指向 root 的指標
-
Root’s parent link
-
資料結構的版本中是寫 null
-
如果是在 CLRS 中是寫指向自己
-
-
-
每個集合有一個代表元素(通常是第一個節點)
struct DisjointSetNode {
    int data;                             // 節點資料
    DisjointSetNode* parent = nullptr;    // 指向代表元素(root)

    // 建構子
    DisjointSetNode(int val) : data(val), parent(nullptr) {}
};
⚙️ 特性與缺點:
-
Find-Set(x):需遍歷整條 linked list,效率低 -
Union(x, y):需將 list 串接並更新代表元,較慢 -
教學常見,但實務較少使用
🧮 2. Array(樹狀結構)表示法
📌 結構概念:
-
使用一個一維陣列
parent[]表示每個節點的父節點 -
若 \(\text{parent}[x] = x\),則 \(x\) 是該集合的 root(代表元素)
-
整個集合是一棵以 root 為根的樹
🔧 優化技巧(結合 size 儲存):
-
若 \(\text{parent}[i] < 0\),表示 \(i\) 是 root,且集合大小為 \(-\text{parent}[i]\)
-
若 \(\text{parent}[i] \geq 0\),表示 \(\text{parent}[i]\) 是節點 \(i\) 的父節點
📊 Array 範例:
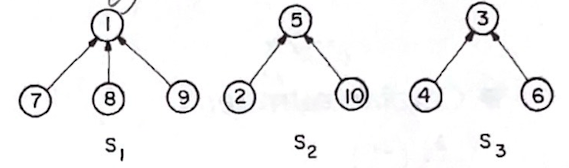
| index | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| data | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| parent | -4 | 5 | -3 | 3 | -3 | 3 | 1 | 1 | 1 | 5 |
📌 解釋:
- \(\text{parent}[1] = -4\) → 節點 1 是 root,集合大小為 4
- \(\text{parent}[2] = 5\) → 節點 2 的父節點是 5
- \(\text{parent}[3] = -3\) → 節點 3 是 root,集合大小為 3
- \(\text{parent}[6] = 3\) → 節點 6 的父節點是 3
📌 Application
Disjoint Set 資料結構的常見應用包括:
-
Kruskal’s Algorithm 中用來判斷是否可以將邊 (u, v) 加入 Spanning Tree
-
若 \(\text{Find-Set}(u) \neq \text{Find-Set}(v)\),則表示不會產生 cycle,可加入
-
避免產生環(Cycle) → Chapter: MST(Minimum Spanning Tree)
-
找出圖中的 Connected Components(連通分量) (CLRS P564)
-
可將每個邊 \((u,v)\) 透過
Union(u, v)合併 -
最後透過
Find-Set(x)確認是否屬於同一個連通分量(Chapter: 6)
#include <bits/stdc++.h>
using namespace std;

struct DSU {
  unordered_map<string,string> parent;
  unordered_map<string,int> rnk;

  void make_set(const string &x) {
	if (!parent.count(x)) {
	  parent[x] = x;
	  rnk[x] = 1;
	}
  }

  string find(const string &x) {
	return parent[x]==x ? x : parent[x]=find(parent[x]);
  }

  void unite(const string &a, const string &b) {
	make_set(a);
	make_set(b);
	string ra = find(a), rb = find(b);
	if (ra == rb) return;
	if (rnk[ra] < rnk[rb]) swap(ra, rb);
	parent[rb] = ra;
	rnk[ra] += rnk[rb];
  }
};

int main(){
  ios::sync_with_stdio(false);
  cin.tie(nullptr);

  string line;
  getline(cin, line);
  istringstream iss(line);
  string token;
  DSU dsu;

  while (iss >> token) {
	vector<string> seg;
	string part;
	stringstream ss(token);
	while (getline(ss, part, '-')) {
	  seg.push_back(part);
	}
	for (int i = 0; i+1 < (int)seg.size(); i++) {
	  dsu.unite(seg[i], seg[i+1]);
	}
  }

  // 輸出每個節點的代表元
  cout << "代表元 (root):\n";
  for (auto &kv : dsu.parent) {
	cout << kv.first << " -> " << dsu.find(kv.first) << "\n";
  }
  return 0;
}
3. 給等位配對資訊,找出等位集合
等位關係(Equivalence Relation)需滿足三個性質:
- 反身性(Reflexive):\[aRa\]
- 對稱性(Symmetric):\[aRb \Rightarrow bRa\]
- 遞移性(Transitive):\[aRb \land bRc \Rightarrow aRc\]
題目:
已知以下等位配對資訊:
請找出所有等位集合。
✅ 解法說明:
-
一開始每個元素都是獨立集合。
-
使用並查集(Union-Find)處理合併操作。
-
最後根據集合代表元(root)分組。
💻 C++ 實作程式碼:
#include <iostream>
#include <vector>
#include <unordered_map>
#include <algorithm>
using namespace std;

class UnionFind {
public:
    UnionFind(int size) {
        parent.resize(size + 1);
        for (int i = 1; i <= size; ++i)
            parent[i] = i;
    }

    int find(int x) {
        if (parent[x] != x)
            parent[x] = find(parent[x]);  // 路徑壓縮
        return parent[x];
    }

    void unite(int x, int y) {
        int rx = find(x);
        int ry = find(y);
        if (rx != ry)
            parent[ry] = rx;
    }

    vector<int> parent;
};

int main() {
    int n = 12; // 範圍:1~12
    UnionFind uf(n);

    // 等位配對資料
    vector<pair<int, int>> relations = {
        {1,5}, {4,2}, {7,11}, {9,10},
        {8,5}, {7,9}, {4,6}, {3,12}
    };

    for (auto [a, b] : relations) {
        uf.unite(a, b);
    }

    // 收集等位集合
    unordered_map<int, vector<int>> groups;
    for (int i = 1; i <= n; ++i) {
        int root = uf.find(i);
        groups[root].push_back(i);
    }

    // 輸出結果
    int set_id = 1;
    for (auto& [root, members] : groups) {
        sort(members.begin(), members.end());
        cout << "Set " << set_id++ << ": ";
        for (int x : members)
            cout << x << " ";
        cout << endl;
    }

    return 0;
}
🧮 Arbitrary Union(i, j) and Simple Find(i) Implementation
這是最基礎的互斥集合實作版本,不考慮 size/rank/path compression 的優化。
🔁 Union(i, j)
// 合併兩集合:將 i 的 root 指向 j 的 root
void Union(Node* i, Node* j) {
    i->parent = j;       // or j->parent = i;
    // 視哪一邊要當作 root 而定
}
-
時間複雜度:\(O(1)\)
-
無優化策略,隨意合併可能導致退化成鏈狀結構
🔍 Find(i)
// 找到節點 i 所在集合的代表元(root)
Node* find(Node* i) {
    Node* j = i;
    while (j->parent > 0) {
        j = j->parent;   // 向上找 root
    }
    return j;
}
-
while (j->parent > 0):代表還沒找到 root -
while (j->parent != j):演算法教科書常見寫法 (CLRS) -
while (j->parent != nullptr):資料結構常見的寫法 -
root 的判斷條件因表示法略有不同(可根據程式語言與資料結構調整)
🧠 時間複雜度分析:
-
若沒有任何優化(例如 Union by Size / Rank 或 Path Compression),則在最壞情況下,所有節點會逐一串接成一條鏈狀結構(linear tree)
-
Find(i)的時間取決於從節點 \(i\) 向上走到 root 的距離 → 即 \(O(h)\),其中 \(h\) 為該集合樹的高度(tree height) -
若進行 \(n - 1\) 次不當的合併(例如總是把新節點接在最深節點下),會導致:
1 → 2 → 3 → 4 → ... → n此時:
-
執行
Find(n),需要從 \(n\) 回溯到 \(1\) -
操作次數為 \(n - 1\) 次
-
-
📌 最差情況: \[ \text{Find}(x) = O(n) \]
-
✅ 若搭配優化策略,時間複雜度可降為:
-
\(\mathcal{O}(\log n)\)(僅 Union by Rank/Size)
-
\(\mathcal{O}(\alpha(n))\)(若含 Path Compression)
-
⚙️ 優化的必要性(Why Optimization Matters)
在最原始的實作中,如果只使用 Arbitrary Union(i, j) 搭配 Simple Find(i),不進行任何優化,會有以下問題:
❗ 問題說明:
- 一開始我們有 \(n\) 個單元素集合(singleton sets):
-
接著進行 \(n - 1\) 次
Union(i, j)操作,試圖將所有集合合併為一個大集合。 -
若合併順序不當(例如總是將新節點合併到最深的樹上),樹會退化成鏈狀:
n → n-1 → n-2 → ... → 2 → 1 -
這種結構稱為 linear tree(線性樹),會導致:
-
Find(i)需要走最多 \(n - 1\) 層才能找到 root -
時間複雜度退化為 \(O(n)\),效能非常差
-
⚙️ 優化方式(Optimization Techniques)
為了避免樹退化成鏈狀結構(linear tree)而導致 Find(i) 效率下降,我們可以設計更聰明的合併與查找策略。
主要有兩大類優化方式:
📦 Union by Size / Weight
合併時,讓節點數較少的集合掛到節點數較多的集合上,避免樹變高。
- 每個集合(即每棵樹)維護一個 size 或 weight 計數
- 每次合併時比較兩個 root 所屬集合的大小,讓小的合併到大的
- 這能保證樹的高度最多為 \(\log n\)
🧾 C++ 實作範例(以負數儲存 size):
// parent[i] < 0 表示 i 是 root,且 abs(parent[i]) 為集合大小
// parent[i] >= 0 表示 parent[i] 是 i 的父節點
void unionBySize(int i, int j, vector<int>& parent) {
    // 找 root
    int rootI = find(i, parent);
    int rootJ = find(j, parent);

    if (rootI == rootJ) return; // 已在同一集合中

    int totalSize = parent[rootI] + parent[rootJ]; // 注意:parent 值為負數

    if (parent[rootI] < parent[rootJ]) {
        // rootI 的集合比較大(數值更小)
        parent[rootJ] = rootI;
        parent[rootI] = totalSize;
    } else {
        parent[rootI] = rootJ;
        parent[rootJ] = totalSize;
    }
}
證明 Union by Weighting 的高度上界
簡單來說:
每次合併時,Weighting Rule 會把「較小的樹」接到「較大的樹」上,因此我們可以假設有兩棵子樹 \(T_a\) 和 \(T_b\) 要合併,它們的節點數分別是 \(a\) 和 \(b=n - a\),不失一般性,我們假設 \(1 \le a \le ⌊n / 2⌋\) 這表示:較小的那棵子樹最多只佔整體的一半大小。
-
當合併時,會有兩種情況:
-
Case 1:兩棵子樹高度不同,也就是說 \(T_b\) 高於 \(T_a\) → 合併後的樹高不變。
o | o 子樹 A(a=2,H(A)=2) o / \ o o / \ o o 子樹 B (b=5,H(B)=3) o / | \ o o o | / \ o o o 最長路徑依然是 B 原本那條長度 3 → H(7)=3 -
Case 2:兩棵子樹高度相同,也就是說 \(H(T_a) = H(T_b)\) → 合併後的樹高會增加 1。
   o
  / \
 o   o
 子樹 C(c=3,H(C)=2)
   o
  / \
 o   o
 子樹 D(d=3,H(D)=2)
 	  o
 	/ | \
    o  o  o
   / \
  o   o
 新樹高度從 2 → 3,因此 H(6)=3
-
不論是哪一種情況,新的樹高都不會超過 \(\lceil\log_{2}(n+1)\rceil\),最壞情況下的高度也只會是 log 等級。
筆記 Union by weighting rule (nodes 的總數)、 Union by Height、Union by ranks (root’s degree) 都是一樣的樹高 \(\lceil\log_{2}(n+1)\rceil\),並且 FIND(X) 時間複雜度 \(O(\log n)\)
🔗 Path Compression (Collapsing Rule)
定義
在 Find(i) 過程中,除了找出元素 *\(i\) 所在集合的根(root)之外,還會將從 \(i\) 到 root 路徑上 所有非 root 的節點 的 parent 直接指向該 root,以「壓扁」整條路徑。
演算法
o1
 │
o2
 │
o3
 │
o4
 │
o5

執行 `find(5)` 後,回彈階段將所有節點指向根 `o1`。

扁平化後(After):

      o1
/   |  \  \
o2  o3  o4  o5
-
設
j = i,一路沿j->parent上溯,直到j->parent == j,此時j即為根。 -
設
k = i,對從i到j之間的每個節點做:-
暫存
t = k->parent -
設
k->parent = j -
令
k = t
-
-
回傳根節點
j。
Node* Find_with_Collapsing(Node* i) {
    Node* j = i;
    // 找到根
    while (j->parent != j) {
        j = j->parent;
    }
    // 路徑壓縮
    Node* k = i;
    while (k != j) {
        Node* t = k->parent;
        k->parent = j;
        k = t;
    }
    return j;
}
📌 時間複雜度
-
每次
Find(i)操作的均攤時間為 \(O\bigl(\alpha(m,n)\bigr)\)-
\(m\) 為操作次數
-
\(n\) 為集合元素數
-
\(\alpha(m,n)\) 是 Ackermann 函數的反函數,增長極為緩慢
-
-
由於 \(\alpha(m,n) = O\bigl(\log^* n\bigr)\) 因此可近似視為常數時間 \(O(1).\)