二項樹、二項堆與費波那契堆
二項樹、二項堆與費波那契堆的重點整理。
Binomial Tree
定義
-
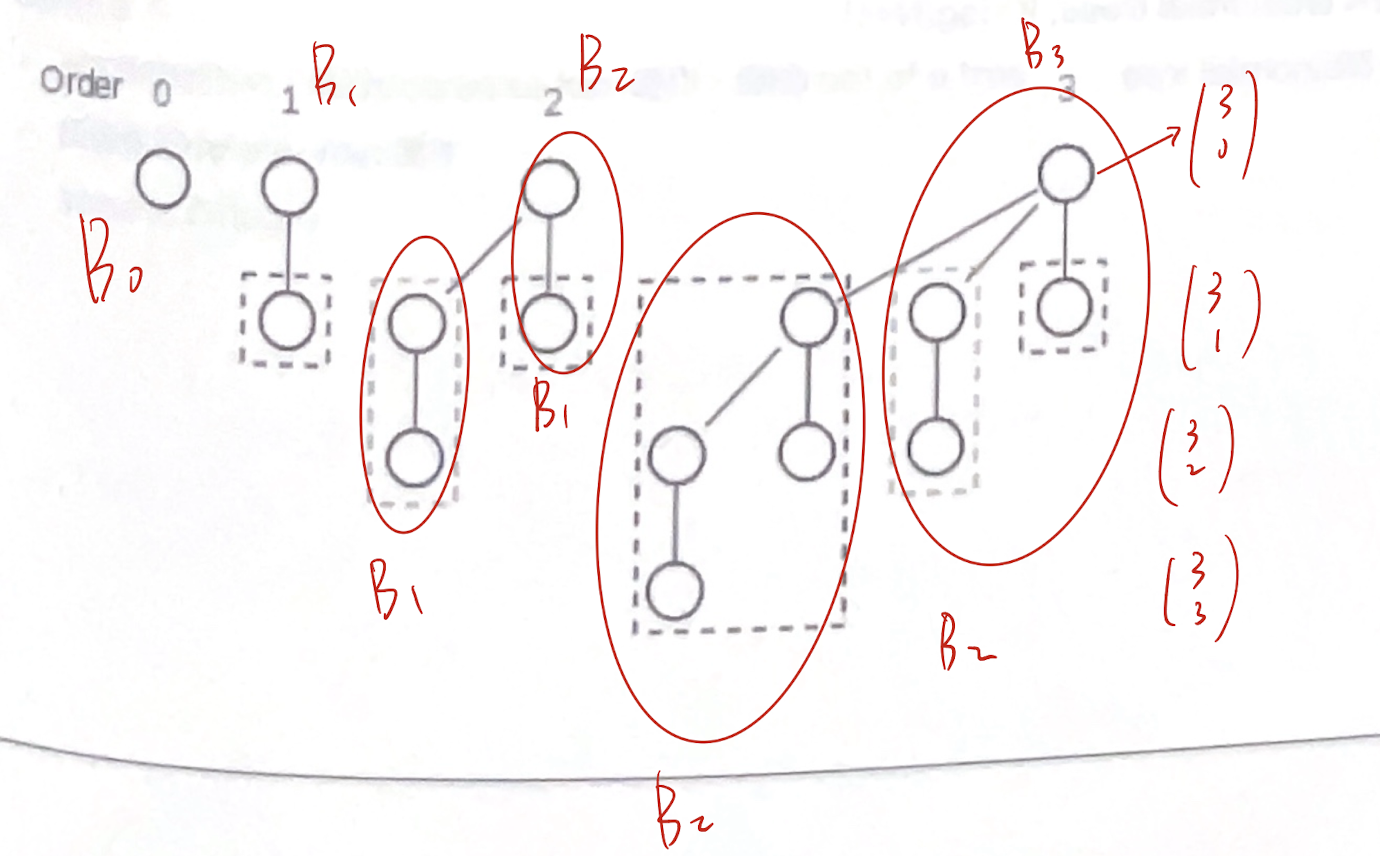
高度為 0 的 Binomial Tree,只有一個節點,記為 B₀(root level = 0 開始)。
-
高度為 k 的 Binomial Tree,記為 Bₖ,是由 兩個 Bₖ₋₁ 的 Binomial Trees 所組成。
-
取其中一個 tree 的 root 作為新的 root。
-
另一個作為其子樹。
-
定理
Binomial Tree 定理
組合恆等式推導
在 Binomial Tree 中,如果我們要計算 Bk 的第 i 層節點數,可以利用兩棵 B(k-1) 來推導:
-
第一棵 B(k-1) 的 第 i 層節點數 會直接成為 Bk 的第 i 層節點數。
-
第二棵 B(k-1) 被接到新的 root 之下,因此它的 第 (i-1) 層節點數 會對應到 Bk 的第 i 層節點數。
因此:
這個關係式對應到組合公式:
Binomial Tree 性質
-
高度為 \(k\) 的 Binomial Tree,第 \(i\) 層的節點數為:\(\binom{k}{i}\)
-
高度為 \(k\) 的 Binomial Tree,節點總數為:
因為:\(B_k = 2 \times B_{k-1}\) 所以:\(|B_k| = 2 \cdot |B_{k-1}| = 2 \cdot 2^{k-1}= 2^k\)
Binomial Heap (Binomial Queue or B-Heap)
定義
-
Binomial Heap 是由 一堆不同高度的 Binomial Trees 組成的集合或是 forest。
-
每一棵樹皆為 min-tree(父節點 ≤ 子節點)。
節點數與樹的數量關係
-
若 Binomial Heap 具有 \(N\) 個節點,最多有 \(O(\log n)\) 棵 Binomial Tree。
-
如果 \(N = 2^k - 1\),則有 \(k\) 棵 Binomial Trees,且高度為 \(0 \sim k-1\)。
-
如果 \(N = 2^k\),則有一棵高度為 \(k\) 的 Binomial Tree。
範例
當 N = 11
- 11 的二進位表示為:
- 所以該 Binomial Heap 由 B₃, B₁, B₀ 三棵 Binomial Trees 組成。
當 N = 18
- 18 的二進位表示為:
- 所以該 Binomial Heap 由 B₄, B₁ 兩棵 Binomial Trees 組成。
操作
Merge (Combine) two Binomial Heaps H1, H2
-
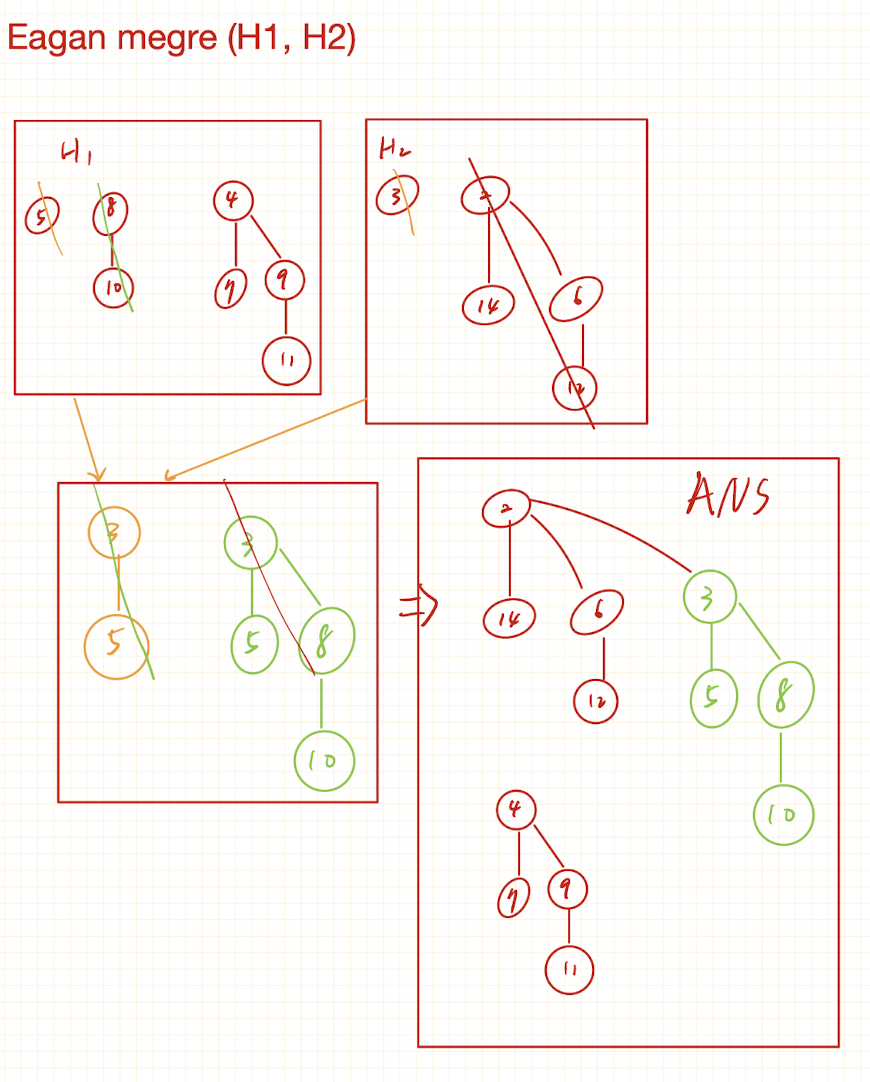
Lazy merge:將 H1 和 H2 合併,具有相同高度的無需合併
- Lazy merge:\(O(1)\)
-
eager merge(Weiss 版本)當兩個 Binomial Heap 進行 勤勞合併 時:
-
若有相同高度的 binomial trees,必須合併成一棵新的樹。
-
合併規則:root 較小的作為新 root,另一棵成為它的子樹。
-
持續合併,直到沒有相同高度的 binomial trees 為止。
-
時間複雜度:\((\lg N)\)
-
範例
- 先合併 3 和 5
- 合併 8-10 跟 3-5 成為 3-5-8-10 後合併 2-14-6-12 成為新樹
- 得到答案
Delete-min of Binomial Heap
-
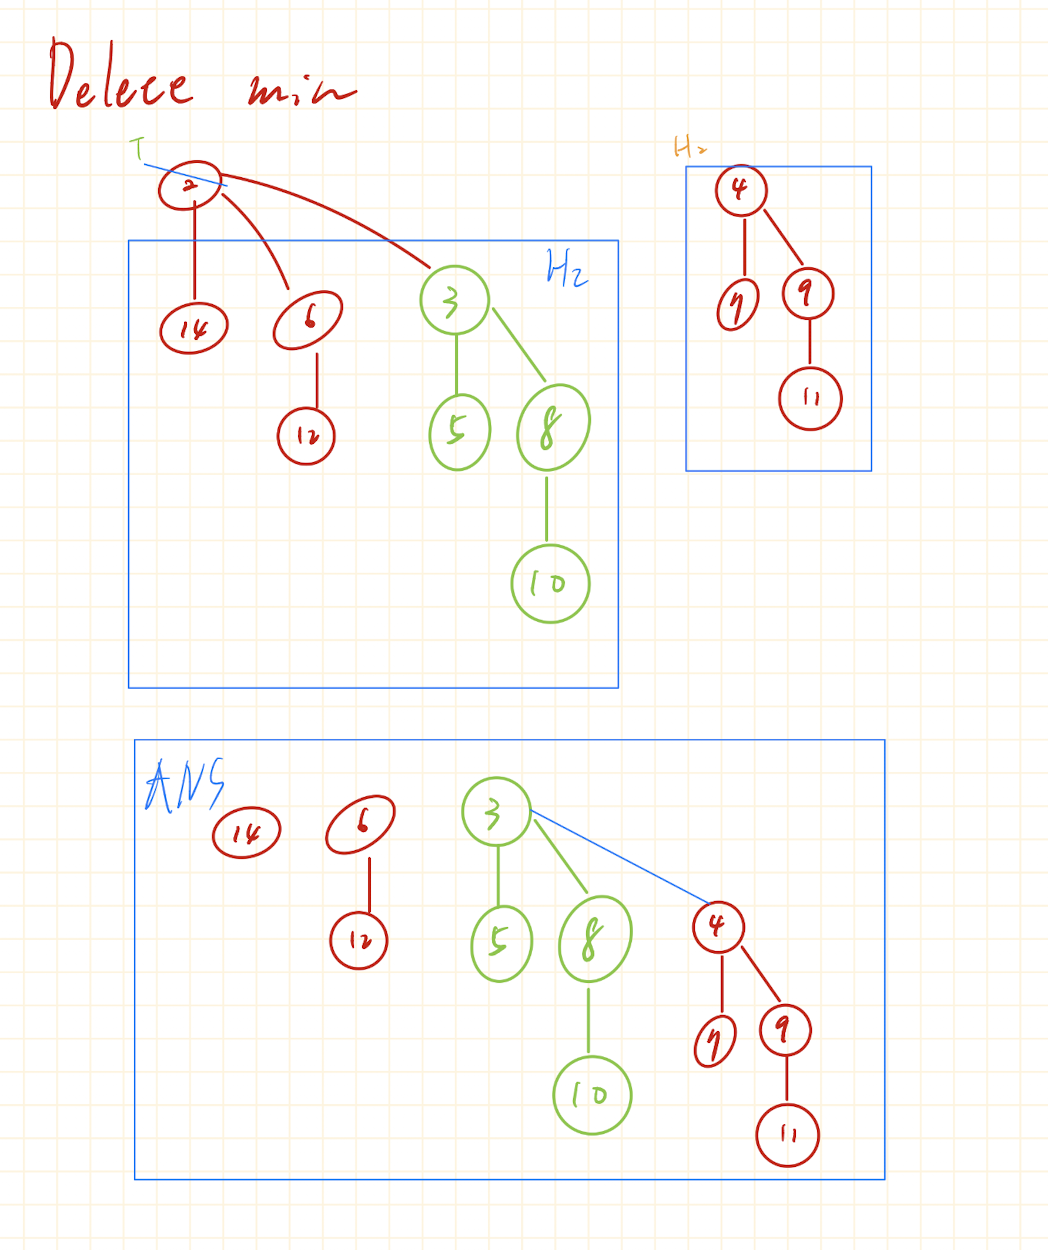
找出最小值的 root 所在樹 T。
-
刪除該 root,剩餘子樹形成新的集合 H2。
-
將 H2 與原本的 H1 合併。
- 時間複雜度:\(O(\log n)\)
範例
- 刪除 2 然後變成很多個 H2
- 高度相同的合併 3-5-8-10 和 4-7-9-11 合併
Insert X in Binomial Heap H1
-
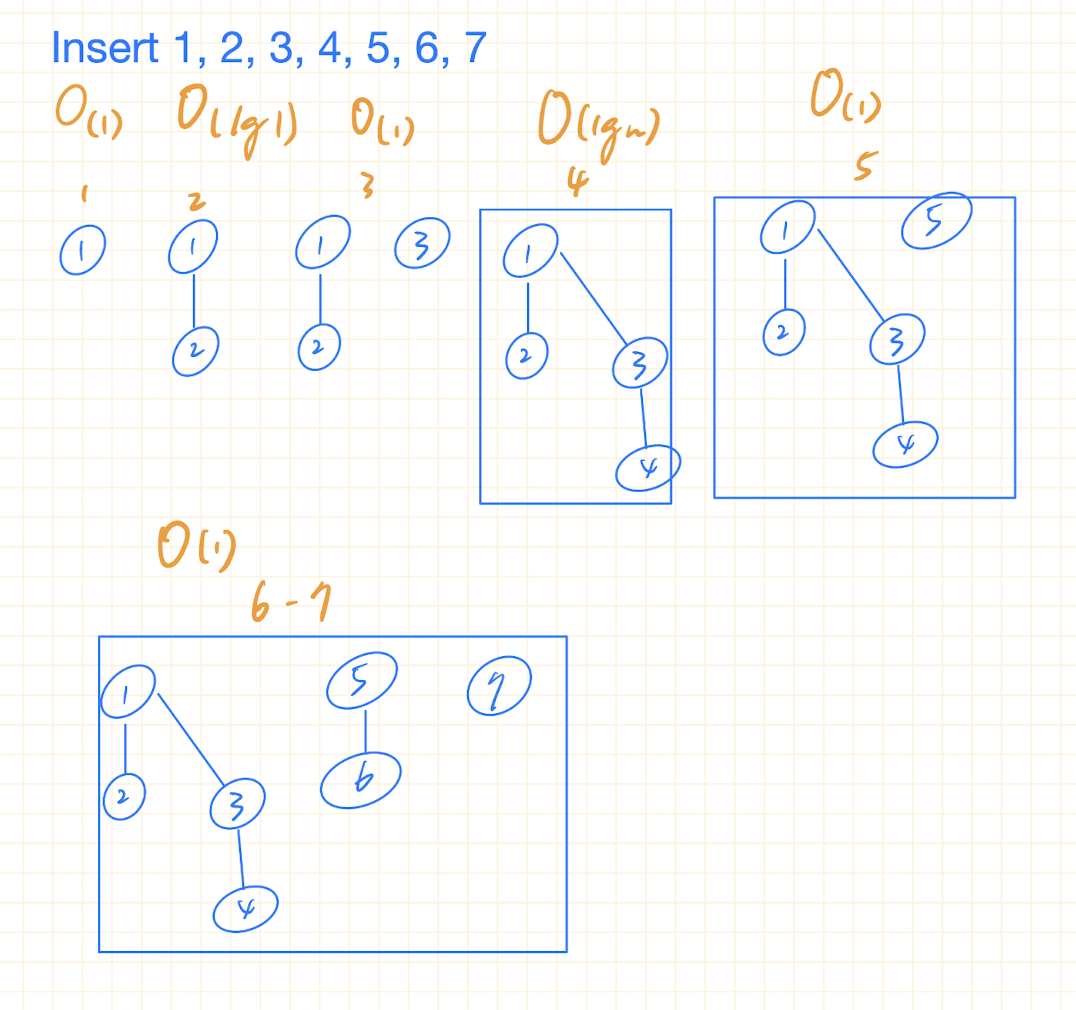
將新節點 X 視為一個單獨的 Binomial Heap H2。
-
執行 Merge(H1, H2)。
-
大部分情況下,插入的時間是 \(O(1)\)。
-
因為插入一個元素時,只是建立一棵 \(B_0\) 並和原本的 Heap 做合併。
-
大部分時候不需要持續合併。
-
-
少部分情況下,插入會觸發一連串的合併,最壞情況需要 \(O(\log n)\)。
-
發生在 Heap 的節點數恰好是 \(2^k - 1\) 的時候。
-
這時候 Heap 中剛好有從 \(B_0, B_1, ..., B_{k-1}\) 的所有樹各一棵,插入後會產生連鎖合併,最後合成一棵 \(B_k\)。
-
範例
複雜度比較表
| 操作 | DS&CLRS | Weiss |
|---|---|---|
| Merge | \(O(1)\) | \(O(\log n)\) |
| Delete-min | \(O(\log N)\) | \(O(\log N)\) |
| Insert | \(O(1)\) | \(O(1)\) |
| Delete-X | \(O(\log n)\) | \(O(\log n)\) |
| Find-min | \(O(1)\) | \(O(\log n)\) |
Fibonacci Heap (F-Heap)
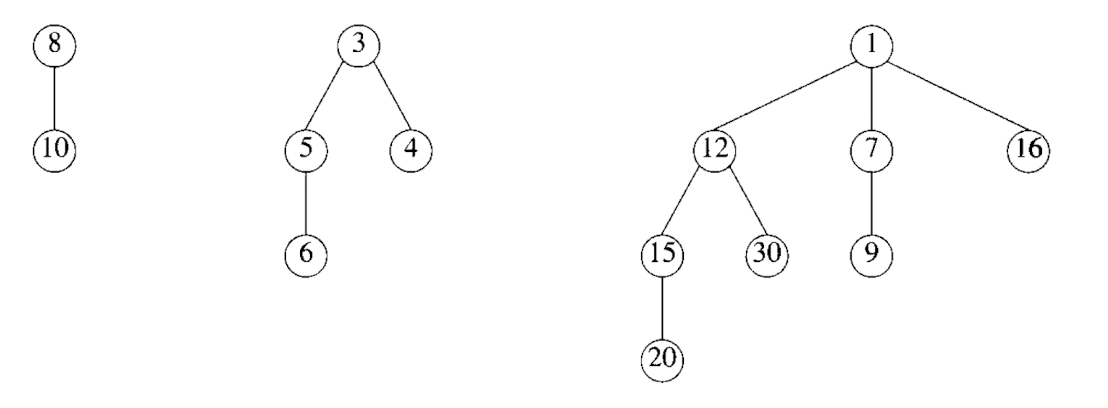
定義
Fibonacci Heap 是一種堆積資料結構,它支援 Binomial Heap 的三種操作:
-
Insert (插入)
-
Delete min / max (刪除最小值或最大值)
-
Combine (Union) (合併)
另外,Fibonacci Heap 還能有效率地支援:
-
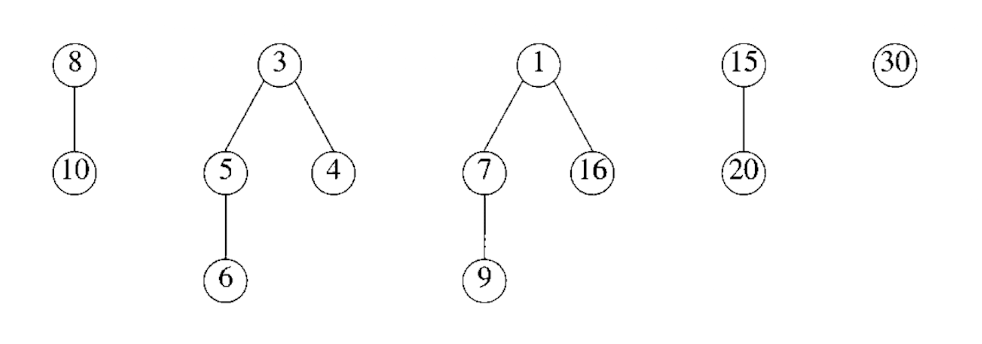
Delete:刪除任意指定節點,Delete 的攤銷時間:\(O(1)\),將原圖刪除 12 後。
-
Decrease-key:將指定節點的鍵值減少,Decrease-key 的攤銷時間:\(O(\log n)\)。
- Binomial Heap 的操作,在 Fibonacci Heap 上也能以相同的漸進時間完成。
種類
-
Min-Fibonacci Heap:由多棵 min-tree 組成。
-
Max-Fibonacci Heap:由多棵 max-tree 組成。
在實作與分析中,通常專注於 Min-Fibonacci Heap,簡稱 F-Heap。
Binomial Heap 可以看作是 Fibonacci Heap 的特例,因此所有 Binomial Heap 的例子也都是 F-Heap 的例子。
結構特徵
-
在每個節點中,除了 Binomial Heap 的基本欄位外,還額外增加:
-
parent:指向父節點。
-
child-cut:用於輔助管理樹結構,特別是在 decrease-key 時。
操作與時間複雜度
| 操作 | 攤銷時間 |
|---|---|
| Insert | O(1) |
| Merge (Union) | O(1) |
| Find-min | O(1) |
| Delete-min | O(log n) |
| Decrease-key | O(1) |
| Delete (任意節點) | O(log n) |
Decrease-key
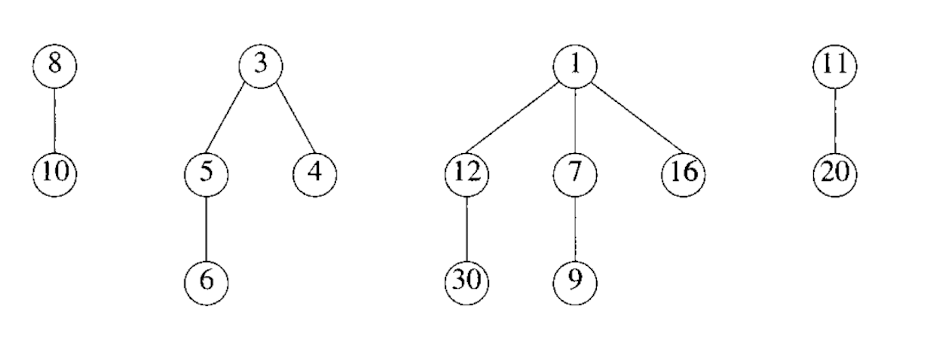
將原圖把 15 減掉 4 之後的變化
重點說明
-
當要減少的節點是 Root:
-
直接把 \(key\) 值改小即可。
-
因為它仍然在 root list 裡,且不會破壞 heap 性質。
-
操作時間為 \(O(1)\)。
-
-
當要減少的節點不是 Root:
-
如果新的 key 值仍然大於等於父節點,就不用動。
-
如果新的 key 值小於父節點,則違反了 min-heap 性質:
-
把這個節點「切斷」(cut) 從父節點移出。
-
把它放回 root list(成為一棵新的樹)。
-
若父節點之前已經被 cut 過一次,則會觸發 cascading cut(連鎖切割),繼續往上處理父節點。
-
-
cascading cut
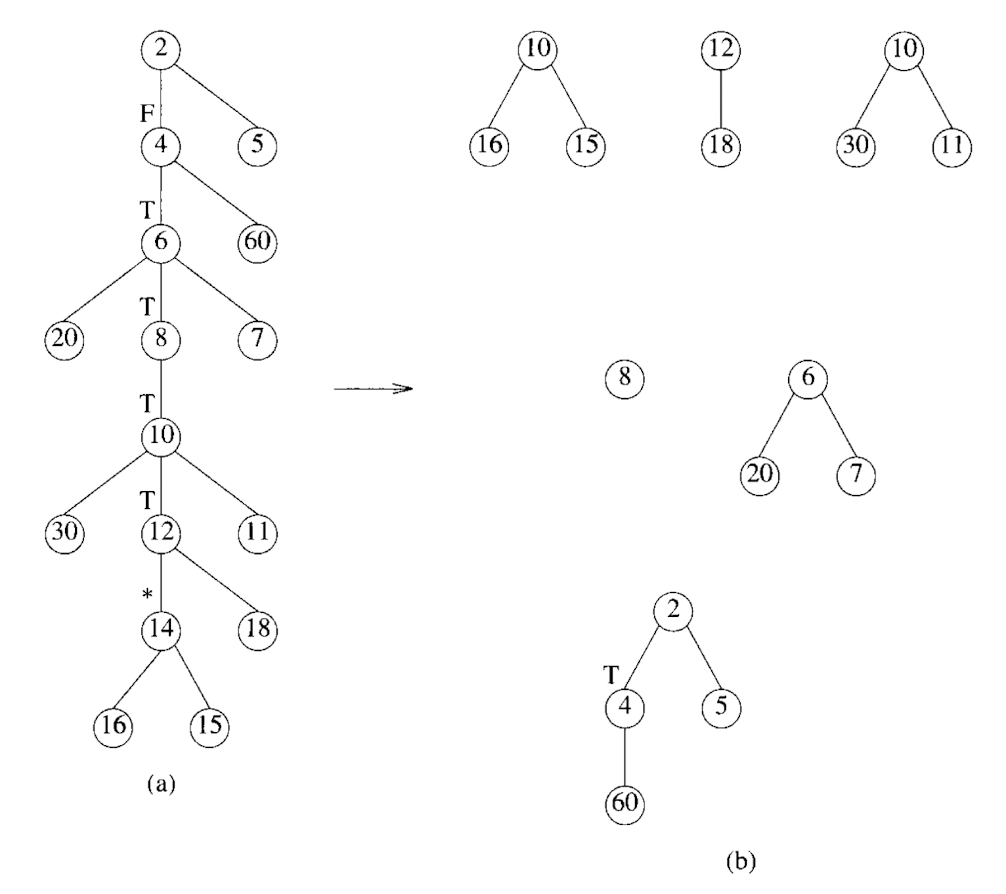
初始狀態 (圖 a)
-
Heap root: 2
-
節點 4, 6, 8, 10, 12 都已經被標記 (child-cut = T),只有節點 4 是 F
-
目標:對節點 14 執行 decrease-key,使得 14 比父 12 還小
執行 decrease-key(14)
-
14 減小 → 比父 12 小 → 切下 14,放入 root list
-
父 12 已經是 T → 連鎖切 → 切下 12
-
父 10 已經是 T → 連鎖切 → 切下 10
-
父 8 已經是 T → 連鎖切 → 切下 8
-
父 6 已經是 T → 連鎖切 → 切下 6
-
父 4 是 F → 改成 T,停止
結果狀態 (圖 b)
Application of Fibonacci Heaps (F-Heaps)
主要應用
Fibonacci Heaps 的一個經典應用是在 單源最短路徑演算法 (Single Source Shortest Path, Dijkstra’s Algorithm) 中。
-
Delete-min:對應於每次從未處理頂點中,取出 \(distance(i)\) 最小的點並加入集合 \(S\)。
-
Decrease-key:對應於更新該點相鄰頂點的距離。
複雜度分析
-
Insert:\(O(1)\)(用來初始化 \(n−1\) 個頂點)
-
Delete-min:執行 \(n−2\) 次,每次 \(O(\log n)\)
-
Decrease-key:最多執行 \(e\) 次,每次 \(O(1)\) 攤銷時間
總時間:
與其他方法比較
-
Array:\(O(n^2 + e)\)
-
Binary Heap / Binomial Heap:\(O((n+e) \log n)\)
-
Fibonacci Heap:\(O(n \log n + e)\)
意義
-
在稀疏圖 (邊數 \(e \approx n\)) 下,F-Heap 對 Dijkstra 提供 漸進上的改進。
-
如果要做 All-Pairs Shortest Path (每個節點都當作源點跑一次 Dijkstra),整體複雜度變成:
- 這比傳統 \(O(n^3)\) 動態規劃方法更快(當 \(e < n^2\) 時)。
總結
F-Heap 的核心應用:
-
單源最短路徑 (Dijkstra)
-
最小生成樹 (Prim’s Algorithm)
-
任何需要大量 decrease-key 的圖演算法
關鍵價值:大量 decrease-key 時,能把複雜度從 \(O((n+e) \log n)\) 改進到 \(O(n \log n + e)\)。